视频天然包含极高的信息密度,但“有视频”与“有可训练数据”之间,其实隔着很长的一条链路。
一段随手拍摄的原始视频,最初只是连续的 RGB 像素和声音。它没有明确告诉模型“谁在做什么”“动作从什么时候开始”“操作了哪个物体”“物体发生了什么变化”,更不会天然提供跨视角对应关系、三维姿态、技能水平或者未来动作这样的监督信号。真正决定一个视频数据集价值的,往往不是拍摄了多少小时,而是研究者如何把这些原始记录逐步整理、对齐、标注和结构化,使其成为能够被模型读取、训练和评估的 Corpus。
这里选择 EPIC-KITCHENS-100、Ego4D 和 Ego-Exo4D 三项具有代表性的工作,并不是为了简单罗列三个第一人称视频数据集,而是希望沿着它们的发展脉络,观察一套视频数据体系究竟是怎样被构建出来的:
从摄像机如何部署、参与者如何采集真实行为开始,到视频如何经过叙述、转录、时间切分、空间标注和语义整理;再到这些结构化信息如何进一步被组织成动作识别、状态变化、记忆、预测、跨视角关联、姿态估计和熟练度评估等具体学习任务。
三项工作的规模和复杂度逐步提升,但背后的逻辑始终一致:
先记录真实世界,再把连续的视频拆解成机器可以理解的监督信号,最后围绕这些信号构造可训练、可评估、可持续扩展的数据集。
理解这一过程,是理解数据飞轮的第一步。因为只有知道“训练数据究竟是怎么生产出来的”,后面讨论自动标注、数据筛选、模型反馈、合成数据乃至自动化数据飞轮,才不会变成凭空出现的一堆术语。
EPIC-KITCHENS-100
数据集构建流程
EPIC-KITCHENS-100 数据集是自中心化数据集,作为 EPIC-KITCHENS 的扩展版本,能够捕捉到人们在厨房中各种无剧本、未经编辑的物体互动场景。
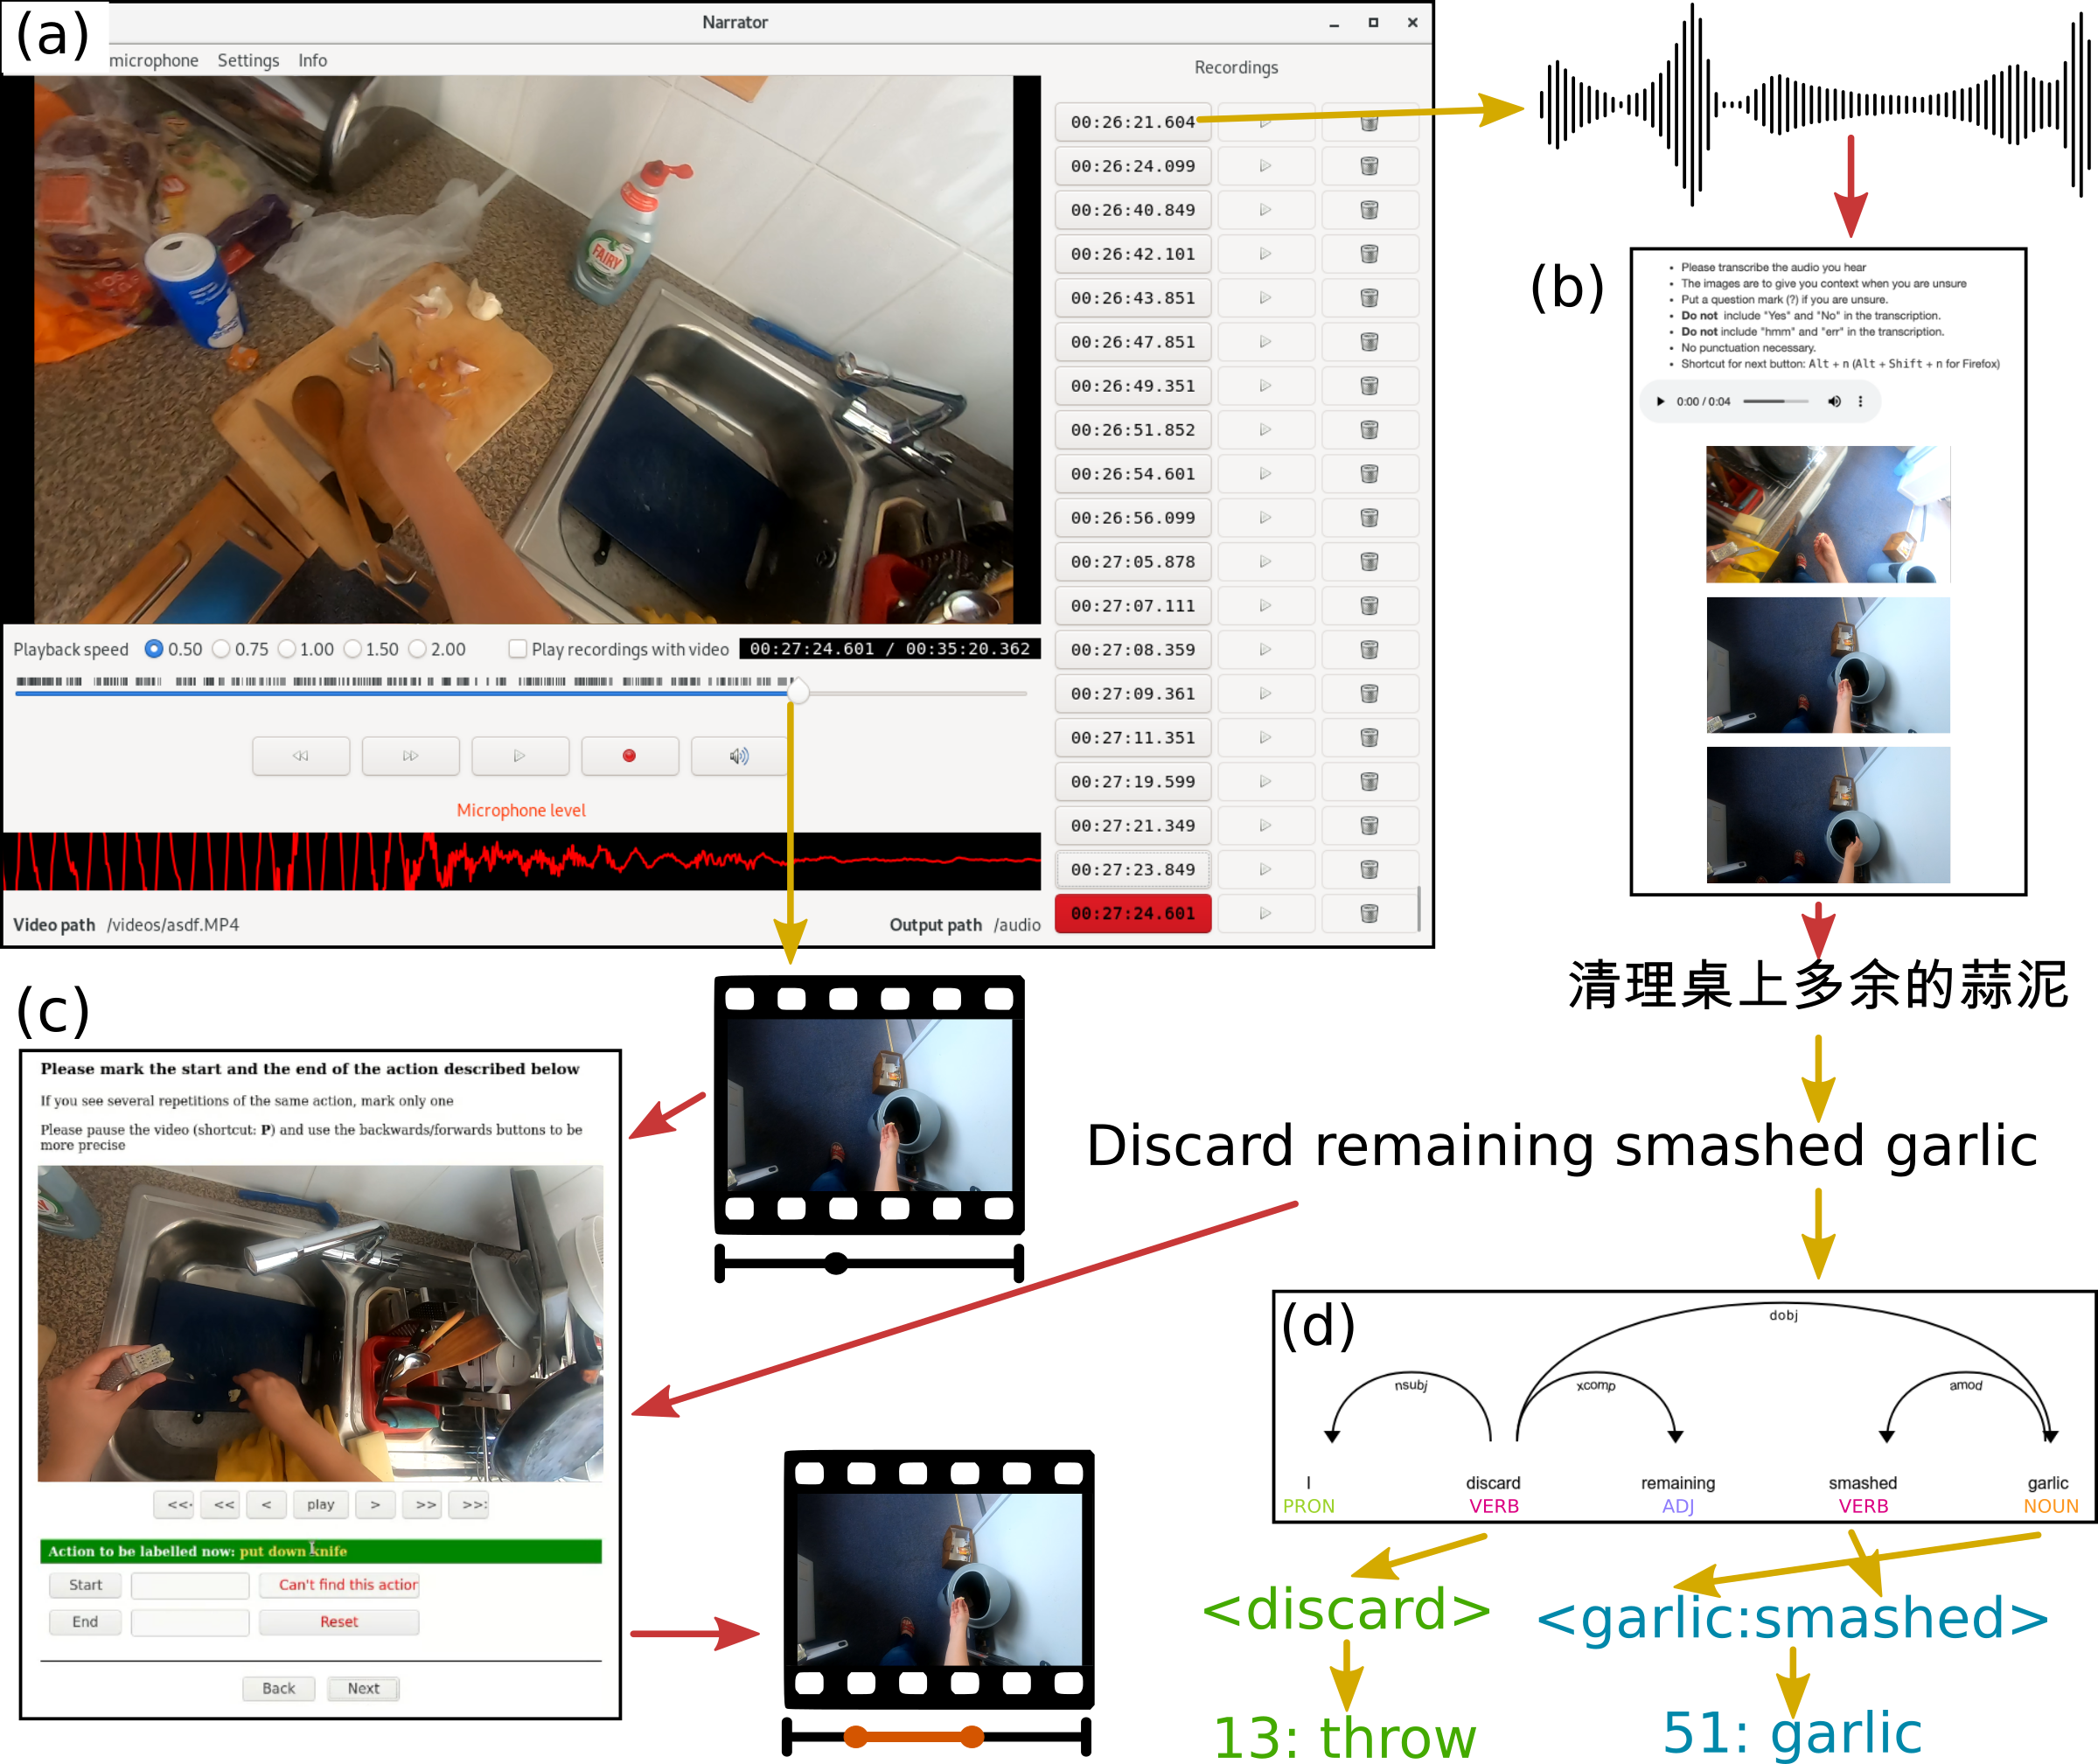
该数据集的原始视频来自于摄像机 GoPro Hero7,都是参与者收集的 2 到 4 天内的典型厨房活动录像。在这个阶段,他们只专注于做动作,不需要说任何话。
当视频录制完成并提交后,参与者会坐在电脑前,使用专门开发的软件界面来标注自己刚刚录好的视频:
- 观看回放:参与者开始播放自己刚才做家务的视频。
- 按下暂停并说话:当看到视频里自己做了一个动作(比如“切番茄”),他们会按住键盘上的一个键,视频画面随即暂停。此时,他们用母语说出这个动作(“我正在切番茄”)。
- 松开继续:说完后,松开按键,视频继续播放,直到看到下一个动作。
- 纠错与修改:如果刚才说错了,或者漏掉了某个重叠的微小动作,他们还可以倒回去,听取、删除或重新录制那段语音。
然后,转录员通过结合视频和音频,把音频信号转化为计算机能理解的、结构化的文本内容,防止原始数据中的噪声和不规范现象。
进一步通过语法解析与分类 (Parser & Clustering),精炼和提取上一步的文本内容,挑出重点词 (动词+名词) 以精准抓取关键信息,同时通过合并同义词的方式调整聚类、减少歧义。
然后,进行时间对齐 (Temporal Annotation),标注清楚每个动作在视频里从几分几秒开始,到几分几秒结束(When)。
最后,进行自动空间定位与抠图 (Spatial Annotation),把视频里出现的各种对象在画面里的具体像素坐标全部圈了出来。它直接用模型针对视频的每一帧(或高频采样的帧)进行全局的自动标注和提取,而不是只注释之前标出的名词。
不同任务评测
六大挑战任务被用于评估该数据集的效果:动作识别、弱监督动作识别、动作检测、动作预判、无监督域适应和多实例动作检索。
动作识别 (Action Recognition)
任务定义与输入:输入为经过裁剪的视频片段 (包含确切的起始与结束帧),目标是预测片段中的动作类别。
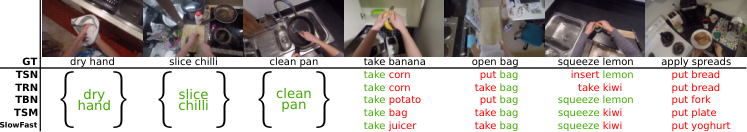
评测路径与输出:输出由“动词 + 名词 + 动作”构成的分类预测。评测使用训练集优化超参数并在测试集评估,对比了 TSN、TRN、TBN、TSM 和 SlowFast 等主流模型,评估指标为 Top-1 和 Top-5 准确率 (Accuracy) 。
基线效果:SlowFast 和 TSM 模型表现最佳。以验证集为例,SlowFast 的动词准确率为 65.56%、名词准确率为 50.02%、整体动作准确率为 38.54%。
弱监督动作识别 (Weakly-supervised Action Recognition)
任务定义与输入:测试时输入裁剪片段;训练时仅提供单个时间戳(即大致发生位置,无起始和结束边界),大幅降低标注成本。
评测路径与输出:输出片段的动作预测。基线方法对比了“以时间戳为中心提取固定长度片段”以及利用采样分布动态细化训练帧的方案,指标同样为 Top-1/ Top-5 准确率。
基线效果:文献的方案优于固定片段基线。但在测试集上,弱监督方案的动作 Top-1 准确率(21.79%)相比全监督基准 TSN(33.57%)低了约 11%,说明在密集且重叠的动作中,仅靠粗略时间戳进行弱监督仍极具挑战性。
动作检测 (Action Detection)
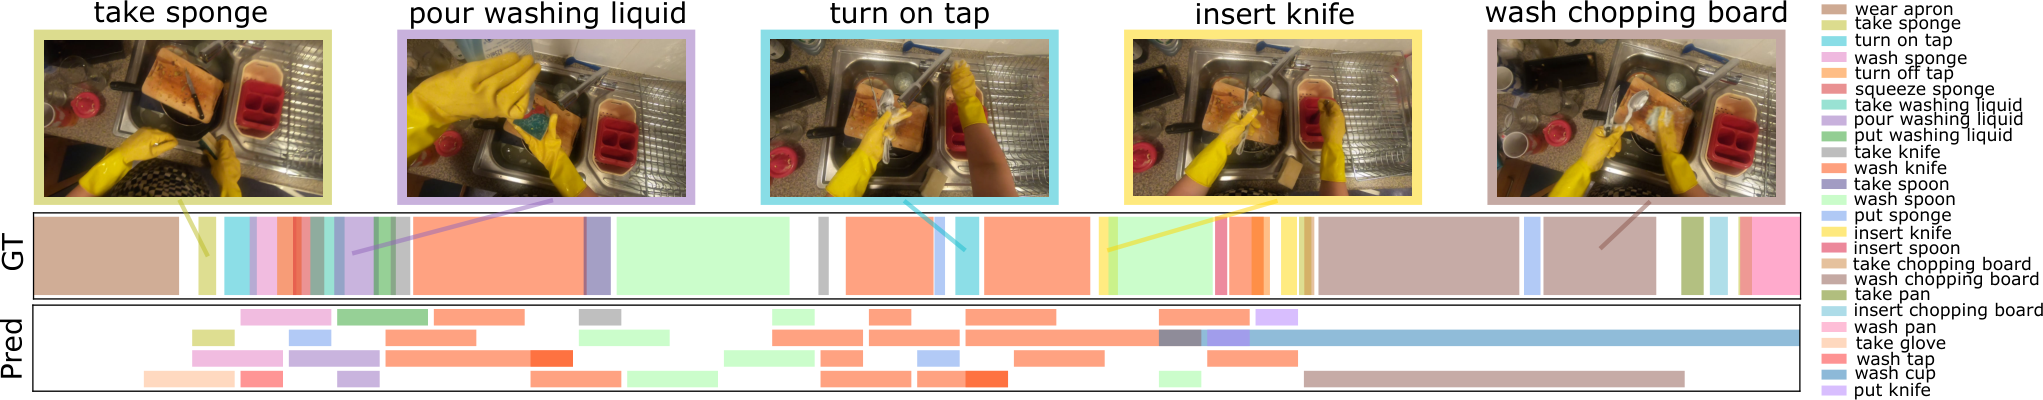
任务定义与输入:输入为未经过裁剪的完整原始视频,模型需要在没有先验时域边界的情况下主动搜寻并识别所有动作。
评测路径与输出:输出视频中所有预测动作实例的元组集合,包含预测的起止时间与动作类别。评测采用“两阶段”基线——先用 BMN 提取候选动作区域,再用 SlowFast 进行分类,评估指标为不同 IoU 阈值(0.1 至 0.5)下的平均精度均值(mAP)。
基线效果:由于动作时长不一且高度重叠,检测难度极大。在验证集上的平均 mAP 仅为:动词 8.36%、名词 6.53%、动作 5.21%;当 IoU 匹配要求提高到 0.5 时,动作 mAP 降至 3.43%。
动作预判 (Action Anticipation)
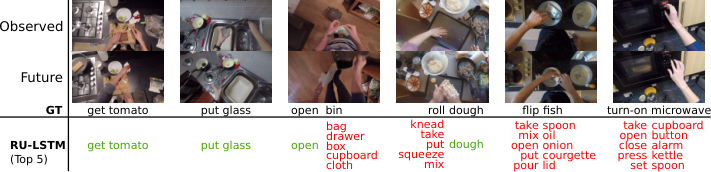
任务定义与输入:模型观察动作开始前任意时长(结束于动作发生前 1 秒)的视频序列,目标是提前预测未来即将发生的动作。
评测路径与输出:模型需要结合观察到的历史动作序列、环境物品状态与潜在意图,输出未来的动作类别。评测采用先前提出的 RU-LSTM 作为基线,评估指标为考虑长尾分布平衡的类均值前 5 召回率(Class-mean Top-5 Recall)。
基线效果:名词的预判表现普遍优于动词,但对长尾类别的预判极为困难。RU-LSTM 在测试集上的召回率为:动词 25.25%、名词 26.69%、动作 11.19%(其中长尾动作类别仅有 7.92%)。
无监督域适应 (Unsupervised Domain Adaptation, UDA)
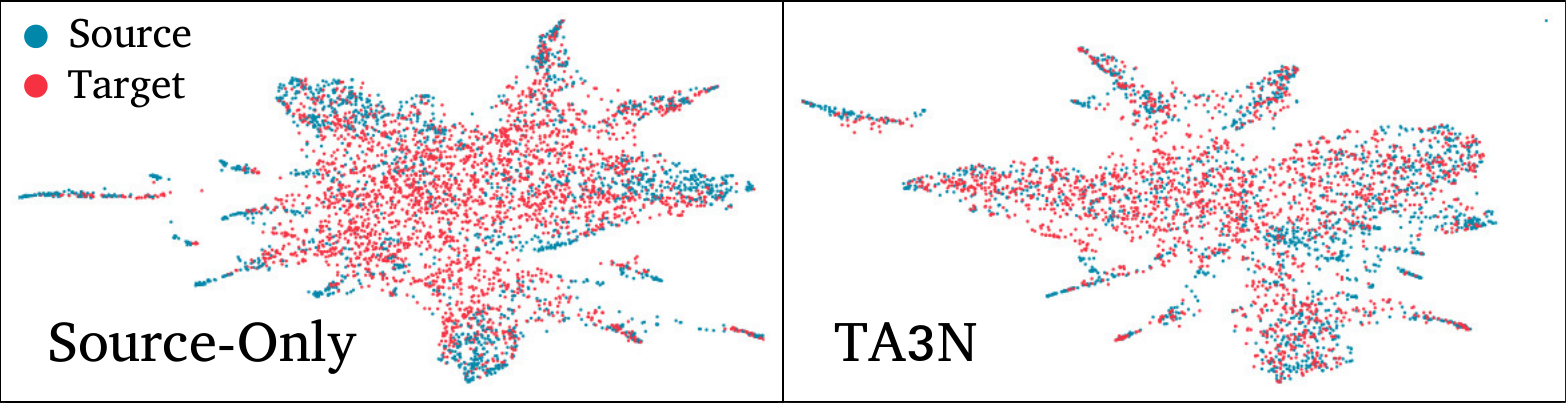
任务定义与输入:源域为 2018 年收集的带标注视频,目标域为 2020 年由相同受试者拍摄的无标注新视频,旨在解决跨时间的“领域偏移”(Domain Shift)问题。
评测路径与输出:目标是直接对无标注的目标域视频片段预测动作分类。评测对比了“仅源域训练”与“仅目标域训练”的上界,并采用 TA3N 算法融合 RGB、光流(Flow)和音频(Audio)三种模态进行特征对齐,评估指标为目标域测试集上的准确率。
基线效果:多模态数据能显著缓解领域差距。仅用源域训练时多模态动作准确率为 16.8%,经过 TA3N 特征对齐后提升至 19.0%(作为对比,直接用目标域标注数据训练的上限为 30.4%)。
多实例动作检索 (Multi-Instance Action Retrieval)
任务定义与输入:包含“视频检索文本”(输入视频片段,对文本标题进行相关性排序)与“文本检索视频”(输入文本,对视频进行排序)双向任务。
评测路径与输出:输出排序后的相关列表。评估引入了基于动词与名词类级别的语义重叠度(IoU)来定义非二元软相关性,除了传统 mAP 外,还采用了支持非二元相关性的归一化折降累计收益(nDCG)作为指标,对比了双层感知机(MLP)与 JPoSE 模型。
基线效果:将标题解耦为动词、名词和动作空间的 JPoSE 模型表现明显优于 MLP。JPoSE 的平均 mAP 达到 44.0%、平均 nDCG 达到 53.5%(MLP 分别为 38.5% 与 48.5%)。
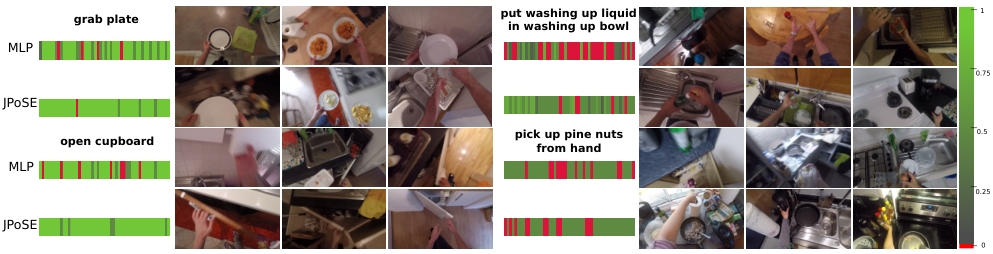
其相关更新见Egocentric Datasets & Benchmarks。
Ego4D
数据集构建流程
视频采集
Ego4D 项目由来自 9 个大洲 5 个国家的 14 个团队组成(详见图 1)。每个团队招募了参与者,让他们在 1 到 10 小时内佩戴摄像头,这样在第一次数据发布中共有 931 名参与者使用了摄像头,共计 3,670 小时的视频数据。这些参与者来自 74 个不同的城市,通过口口相传、广告宣传以及社区公告板上的宣传来招募成员。一些团队则招募了那些从事具有独特视觉环境的职业的人士,比如面包师、木匠、园艺师或机械师等。
项目团队通过参考调查报告和资料,确定了视频数据所涵盖的领域和场景:家中(如清洁、烹饪、打理庭院),休闲时间(如手工制作、玩游戏、参加聚会),交通出行(如骑自行车、开车出行),处理日常事务(如购物、遛狗、修理汽车),以及工作场所(如与同事交谈、制作咖啡)。
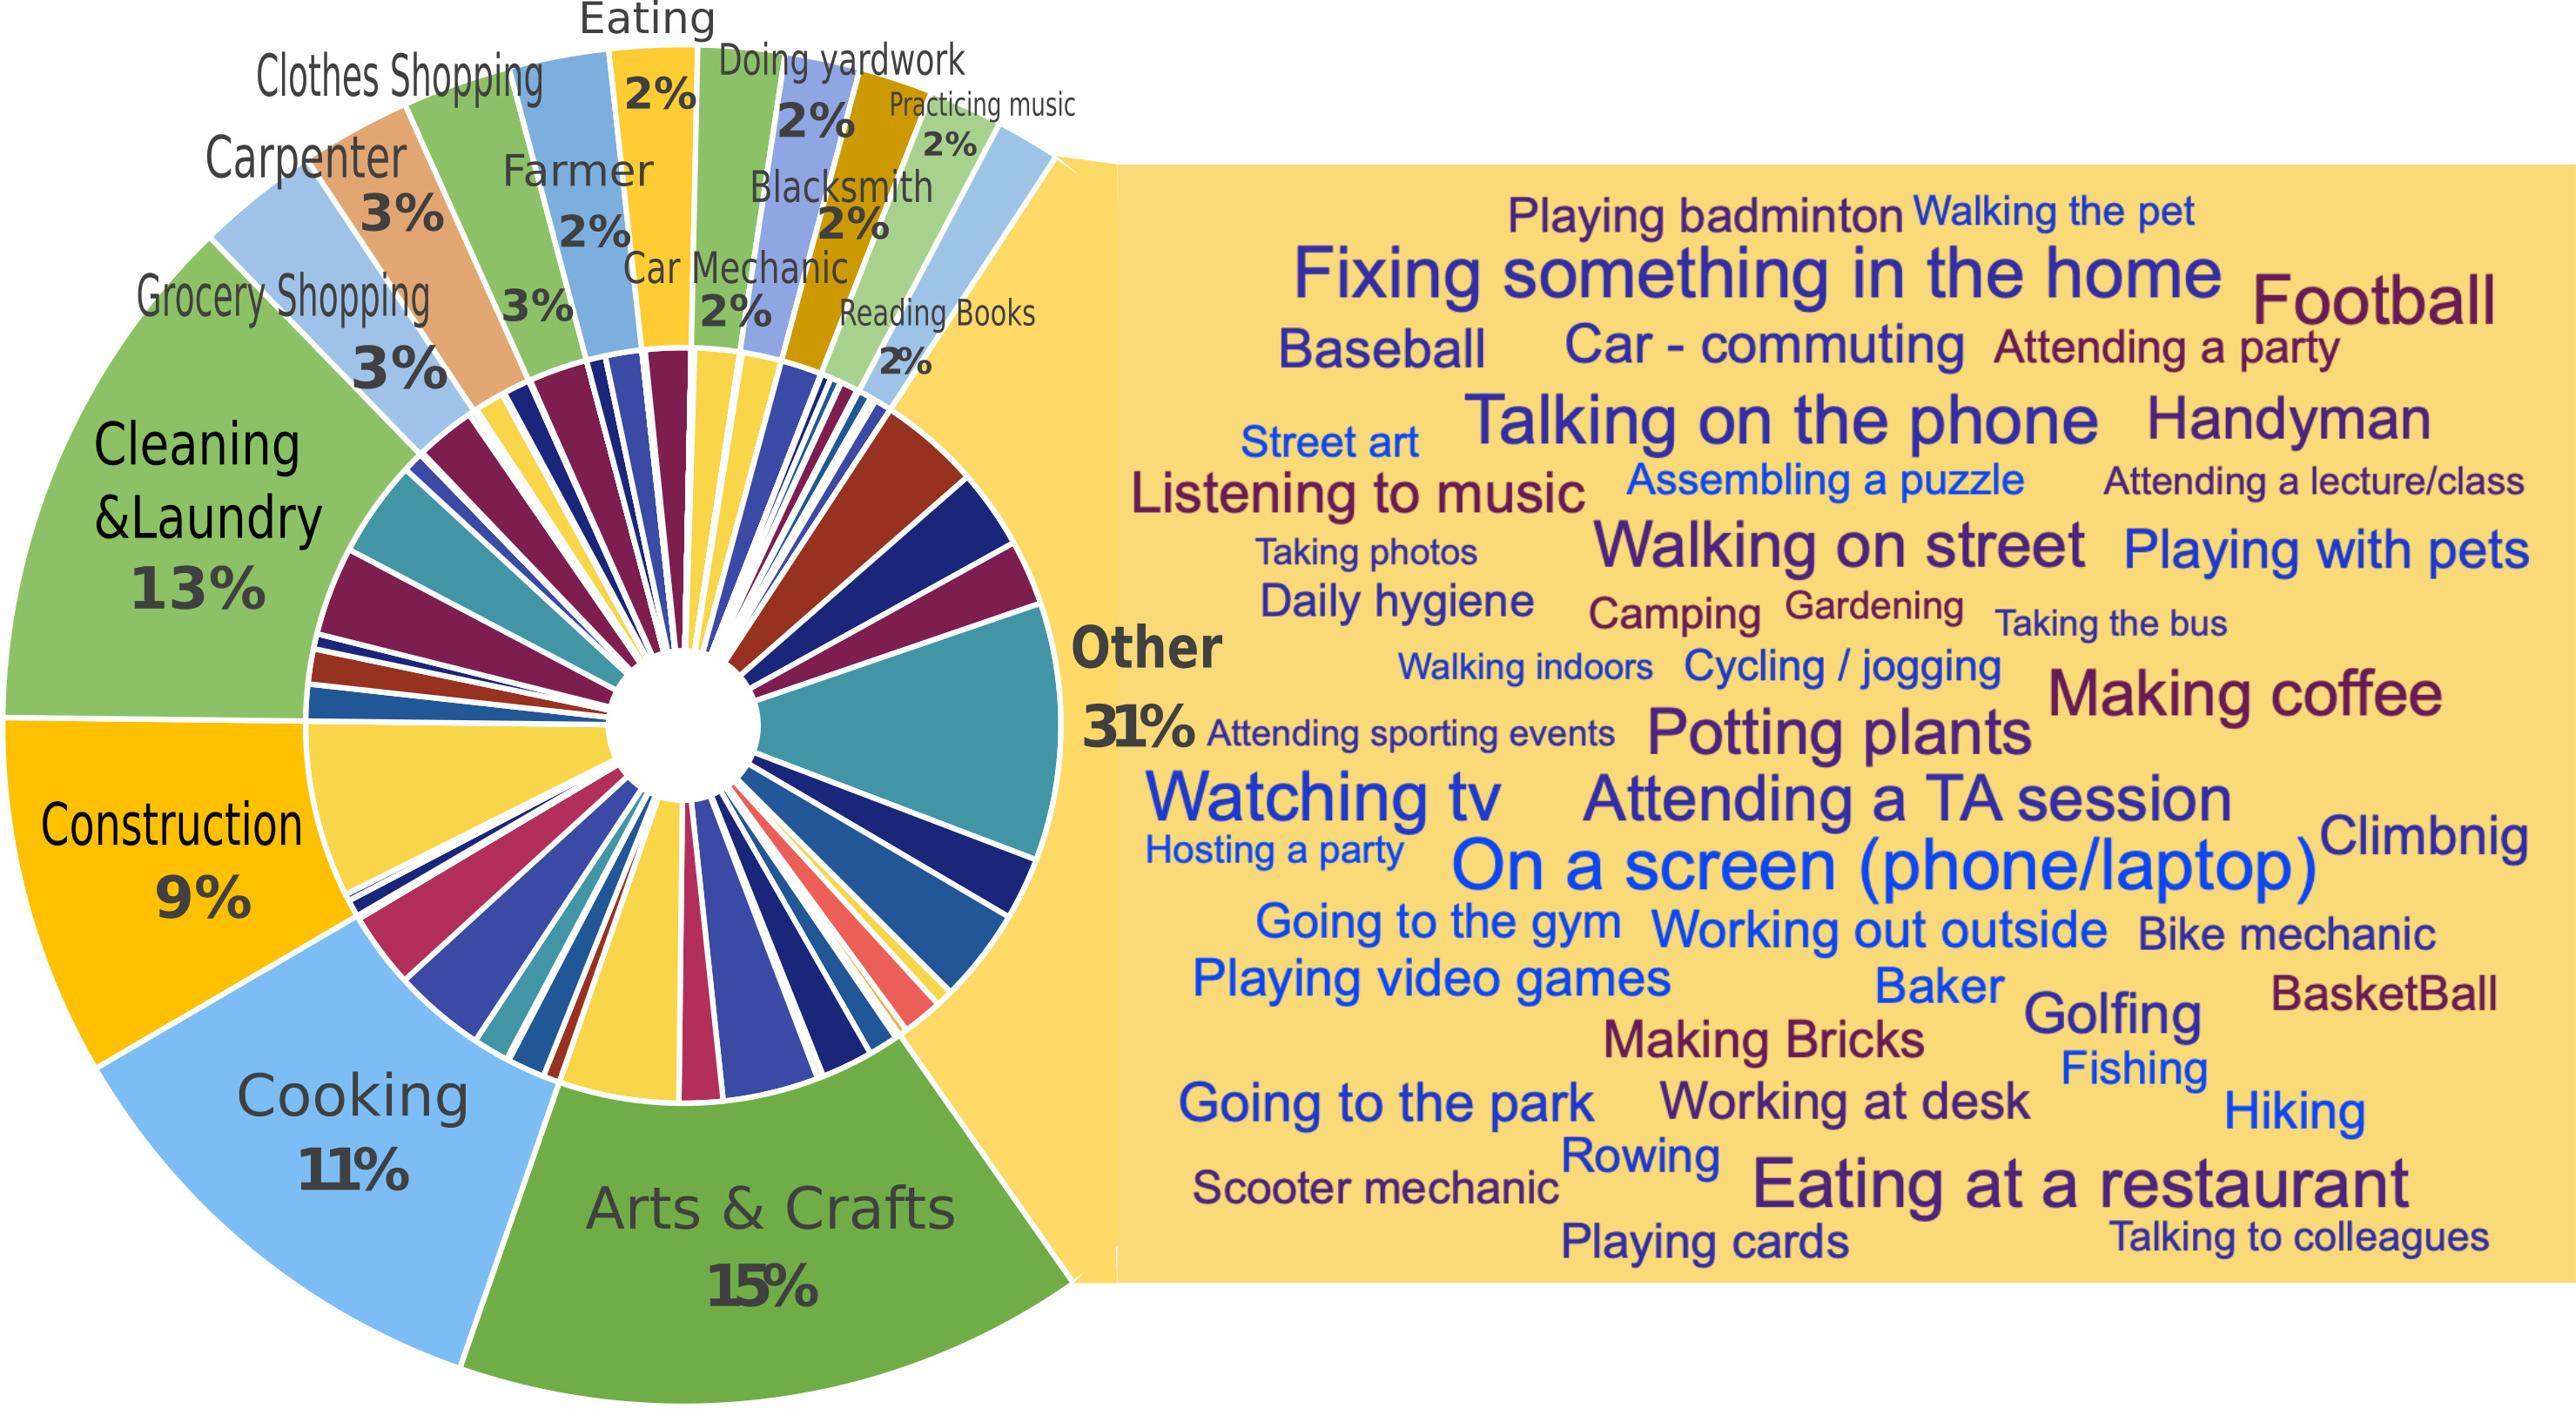
在每一个具体的情景中,通常都会伴随着数十种不同的动作发生。例如,在“木工”这一情景中,就包括用锤子敲打、钻孔、搬运木材等动作。总体而言,项目中 931 位佩戴摄像头的用户为研究者提供了关于世界各地日常活动的丰富信息。
研究者使用了七种不同类型的头戴式摄像头,避免模型因为使用该数据集而过度拟合于某个特定的捕捉设备。
这些设备包括立体摄像头、多个同步的可穿戴摄像头,以及文本说明功能。例如,结合环境的三维扫描数据以及以自我为中心的视频片段(见图 4),我们可以在一个持续性的三维环境中理解动态活动,正如我们在“片段记忆”测试中所做的那样(请参阅第 5.1 节)。多个同步的以自我为中心的视频流可以让我们在社交互动中同时考虑第一视角和第二视角。音频功能则有助于分析对话以及声音场景和事件。
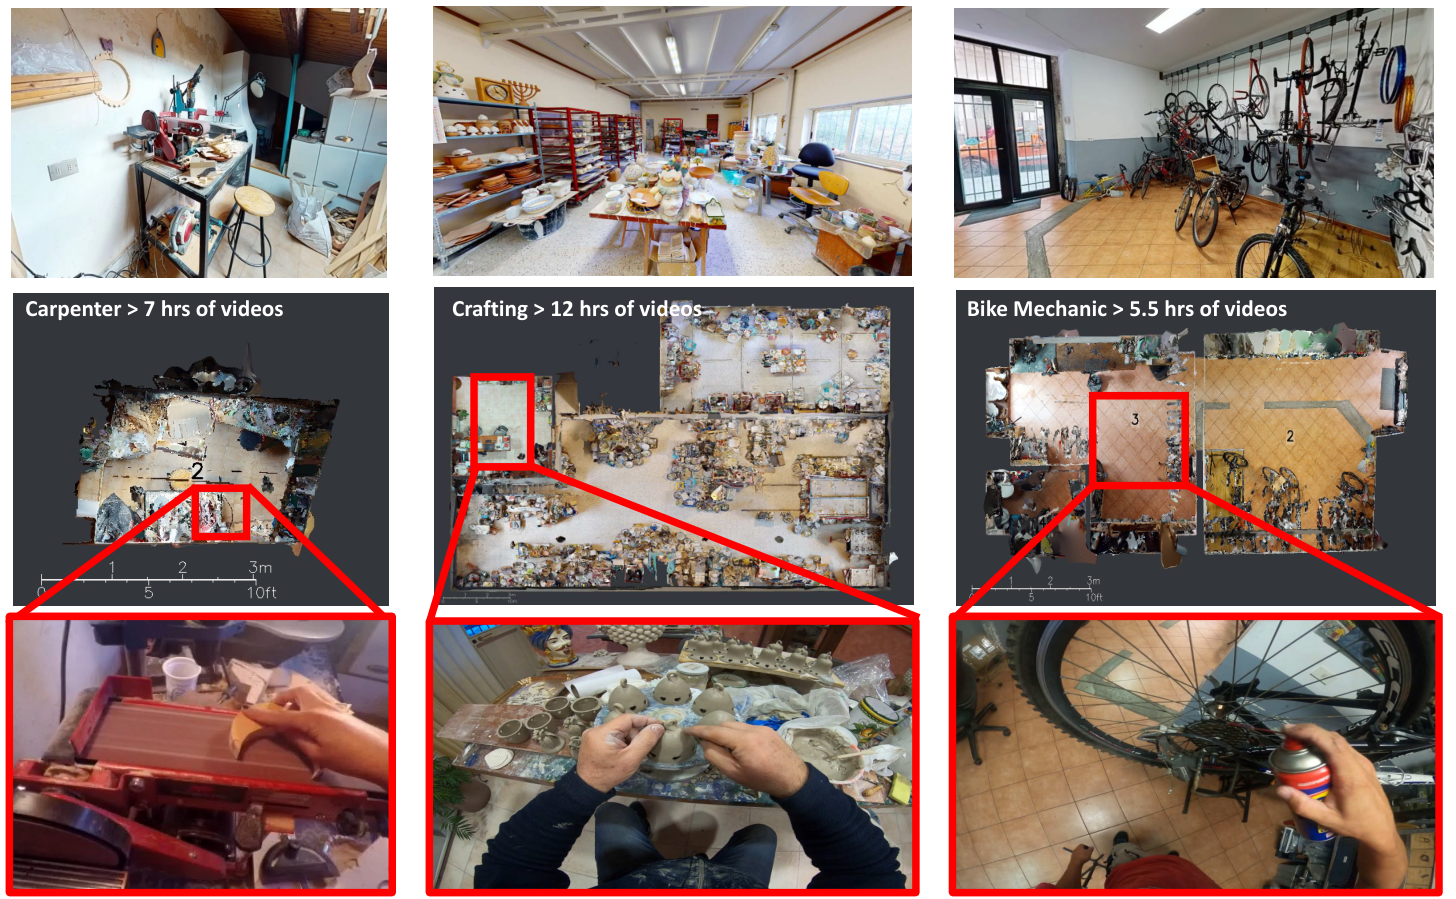
同时,Ego4D 团队开发了一系列的测试套件,用于增强数据集的可访问性。首先,研究团队提供了预计算的动作特征(采用 SlowFast 8x8 架构,并基于 ResNet 101 主干网络进行预训练,适用于 Kinetics 400 数据集),这些特征可以作为任何下游研究的起点。其次,只有部分数据被用作各个基准测试的训练/测试集——而不是全部 3670 小时的数据(详见附录 E)。随着 Ego4D 注释数据的增加,研究团队将创建标准化的小型数据集。最后,研究团队提供了选择仅下载特定基准测试或特定类型数据的选项。
佩戴者叙述
在进行任何注释之前,我们首先会让所有视频通过叙述处理程序。研究团队要求注释者观看一段 5 分钟的视频片段,用几句话对其进行总结,然后再次观看视频,并在每个角色执行动作时暂停,记录下相关的描述语句。进而团队会记录下这些描述语句的时间戳以及对应的自由形式描述。
每个视频由不同的注释者进行两次独立叙述。这些叙述在时间上非常密集:平均每分钟视频有 13.2 句描述,总计 385 万句描述。总体而言,这些描述使用了 1,772 个独特的动词(动作)和 4,336 个独特的名词(对象)。详情请参见附录 D。
这些叙述可以实现以下目标:
- 通过文本挖掘为数据驱动的分类体系构建提供依据,明确各种行为和对象的分类。
- 根据视频内容对其进行排序,将其映射到相应的基准测试中。
- 确定在哪些时间窗口内可以插入某些注释。
除了这些用途之外,这些叙述本身也是数据集的宝贵贡献,对于研究语言与视频之间弱关联关系的研究具有重要意义。据我们所知,我们的数据库是迄今为止规模最大的语言与视频对齐资源库——例如,HowTo100M[157]这个现有的互联网资源库就包含了大量的叙述,不过其中有些叙述包含的是噪声语音,只能提供一些关于所发生事件的简要信息。
基准测试套件
Ego4D 提出了一系列具有挑战性的基准测试任务。这五个基准涵盖了第一人称视频的过去、现在和未来。首批数据集发布包含每个基准测试 48-1000 小时的数据注释,此外还有 3670 小时的叙述数据。附录描述了我们如何根据基准抽样视频,以最大化任务相关性,同时保持地理多样性。
情节记忆 (Episodic Memory)
可穿戴摄像机拍摄的自我中心视频记录了个人日常生活中的人物/内容/时间/地点。这使得图尔文所称的情节记忆[213]——即具体的第一人称体验(“我第一次飞往法国时吃了什么,坐在谁身边?”)的理想位置,与语义记忆(“法国首都在哪?”)有所区别。如果能恰当地索引视觉体验并回答问题,一个能够处理自我中心视频流的增强现实助手,可能会赋予人们超人般的记忆力。
情节记忆的任务定义如下:给定一个以自我为中心的视频和一个查询,Ego4D 情节记忆任务需要定位答案在用户过去视频中可见的位置。其包含三种查询类型:
- 自然语言查询 (NLQ):查询以文本形式表达(例如,“我放了什么进抽屉?”),输出回答是答案可见或可推导的时间窗口。
- 视觉查询 (VQ):其中查询是物体的静态图像,输出在时间和空间上定位该物体在视频中最后一次的出现。空间响应是物体上的二维包围框,可选地是从当前摄像机位置到物体三维包围框的三维位移矢量。VQ 通过图像示例捕捉用户如何向系统教授一个对象,随后询问其位置(“这在哪里 (提供我的钥匙图片)?”)。
- 时刻查询 (MQ):其中查询是高层次活动或“时刻”的名称,响应包含活动发生的所有时间窗口(例如,“我什么时候给孩子们读书?”)。
情节记忆在现有视觉问题基础上有所基础,但也带来了新的挑战。这三种查询都要求在静态环境中进行空间推理,并结合动态视频记录移动和变化的人物;目前的研究大多将这两个元素分开处理。时效性指标鼓励了智能上下文搜索的工作。虽然当前关于语言+视觉的文献主要关注对互联网数据的字幕和问答,而 NLQ 的动机是关于摄像者自身视觉体验的询问,并且基于长期观察进行。VQ 升级了物体实例识别,以处理视频(频繁的视场变化、物体进出视野)以及在三维环境中推理物体。最后,MQ 可以看作是活动检测,但针对摄像机佩戴者的活动。
手与物品 (Hands and Objects)
该基准希望理解摄像机佩戴者当前的活动——即与物体和他人的互动。具体来说,手与物体基准测试捕捉了摄像机佩戴者如何通过使用或操作物体改变物体的状态——我们称之为物体状态变化。虽然将木材切成两半可以通过多种方法实现(例如各种工具、力、速度、握把、端部执行器),但都应被视为同一状态变化。这种泛化能力将使我们更好地理解人类行为,并训练机器人从视频中的人类演示中学习。
Ego4D 将对象状态变化解释为包括各种物理变化,包括大小、形状、成分和纹理的变化。对象状态变化可以沿着时间轴、空间轴和语义轴观察,进而引出以下三个任务:
- 不可回头时间定位:给定一段状态变化的短视频片段,目标是估计包含不可回头点(PNR)(状态变化开始的时间点)的关键帧。
- 状态变化对象检测:给定三个时间帧(前、后、PNR),目标是回归正在发生状态变化的对象的边界盒。
- 对象状态变化分类:给定一个短视频片段,目标是分类对象状态变化是否发生。
Ego4D 根据可能涉及手工与物品互动的活动(如编织、木工、烘焙等)选择注释数据:首先给每个叙述的手与物体的互动做标记,每个帧标记三个时间点(前、PNR、后),以及三个帧中手、工具和物体的边界框;同时还注释了状态变化类型(移除、燃烧等)、动作动词和宾语名词。
如何理解PNR
PNR,Point of Return (不可回头点),指物理状态变化刚开始发生、且不可逆转的那一瞬间。
具体来说:
- Pre(前):变化还没发生(黄瓜是完整的)。
- PNR(中/关键点):变化刚刚发生(刀刚切进去)。
- Post(后):变化已经完成(黄瓜分成了两截)。
例如:- 切黄瓜:刀刃刚好切破黄瓜皮、深入瓜肉的那一帧(切开就合不回去了)。
- 倒牛奶:盒口倾斜、第一滴牛奶刚刚离开盒口落下的那一帧。
- 点火:火柴擦出火花、纸张被引燃的第一帧。
对象状态变化的时空特性是通过以秒为单位测量的绝对时间误差来进行评估的。而对象状态变化类别的识别则通过分类准确率来进行评价。对于状态变化对象的检测,则通过平均精度(AP)来进行评估。
视听分割聚类 (Audio-Visual Diarization)
该部分 Ego4D 设计了两个任务,目的是理解相机佩戴者和其他人的当前互动。人们使用口语交流,这使得在商务会议和社交场合捕捉对话内容成为一个极具科学和实际价值的问题。虽然分割聚类一直是语音识别领域的常见问题,Ego4D 引入了两个新方面:
- 视频和音频的同时捕捉。
- 对话参与者的自我中心视角。
视听分割聚类部分基准由四个任务组成:
- 对参与者(即候选说话者)在视野(FoV)中的定位与跟踪。每个参与者的面部周围标注了一个边界框。
- 主动声源检测,每个被追踪的声源都被赋予匿名标签,包括摄像头佩戴者,但虽然摄像头从未出现在视觉视野中。
- 对每位说话者的语音活动进行分割聚类,即提供与该说话者在片段中语音活动对应的时间段。
- 每位演讲者的演讲内容转录(本版本仅考虑英语使用者)。
Ego4D 使用标准的多对象跟踪(MOT)指标来评估声源在视觉视野中的定位和跟踪。匿名标签的声源检测通过声源错误率评估,该错误率衡量错误分配标签的比例。Ego4D 采用了经过充分研究的 diarization 错误率(DER)[11]和单词错误率(WER)[114]来对付 diarization 和转录。
社交互动 (Social Interactions)
以自我为中心的视频为研究社会互动提供了独特的视角,因为它捕捉了每个参与者独特视角的言语和非语言线索[115],并促成了具身化方法去理解社会。
针对该部分的基准,Ego4D 当前更侧重于通过注意力和语音对会话互动的多模态理解。具体来说,该部分关注识别针对摄像机佩戴者的交流行为,区别于针对其他社会伴侣的行为:
- 看着我 (LAM):给定一个视频中社交伴侣的面部定位并识别,分类每个可见面孔是否都在看摄像者。
- 与我对话 (TTM):给定一个视频和音频片段,且其跟踪面孔相同,分类每个可见面孔是否在与摄像机佩戴者对话。
社交注释 (Social Annotations) 建立在视听分割聚类 (AV Diarization) 的基础上,给定(1)带有参与者 ID 标签并跨帧追踪的面部边界框,以及(2)在每个帧中识别是否出现面部的社交伙伴是否在发言的相关主动说话者注释,标注者为 LAM 和 TTM 提供每个帧中每个人脸的二进制标签。对于 LAM 来说,标注者会标记可见人物在观看摄像者时的时间段(开始和结束时间)。对于 TTM,则使用 AVD 中的语音活动注释,然后识别语音指向摄像机佩戴者的时间段。
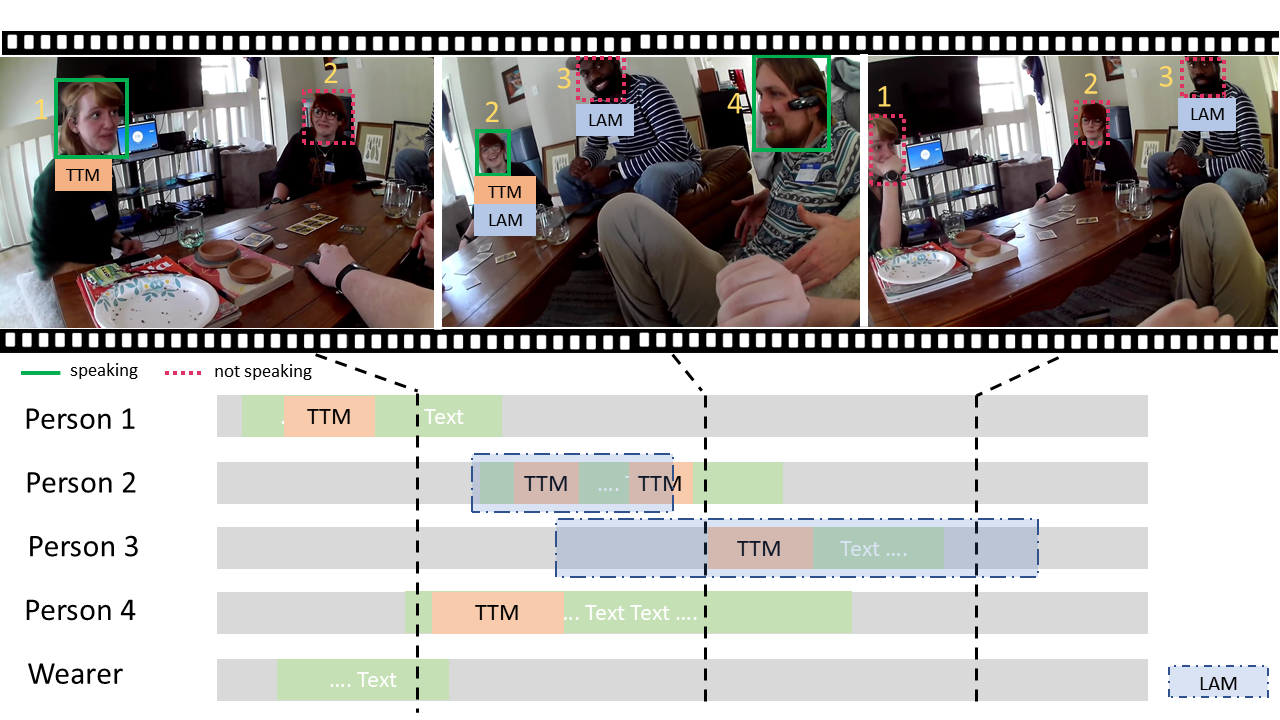
预测 (Forecasting)
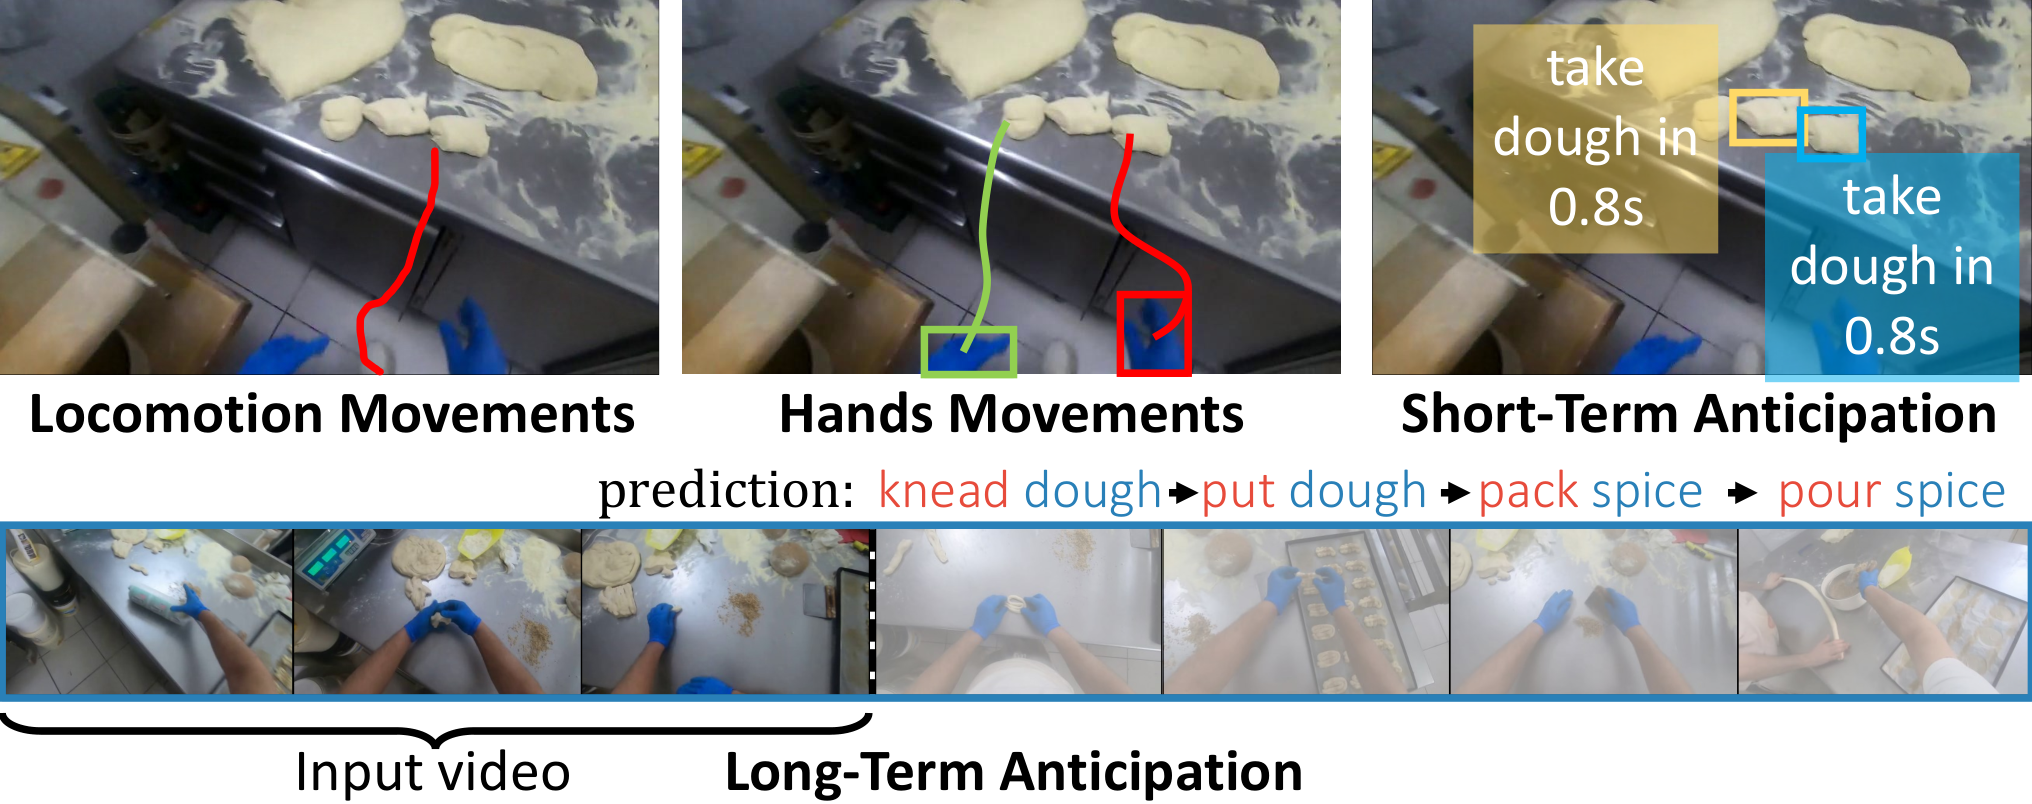
预测动作和交互需要完全理解摄像设备穿戴者的意图,其在 AR 与人机交互中具有广泛应用。该部分包含四个任务:
- 运动预测 (Locomotion Prediction):预测摄像设备穿戴者的一组可能的未来行动平面轨迹。
- 手部运动轨迹预测 (Hand Movement Prediction):在未来帧中,预测摄像设备穿戴者的手部位置。
- 短周期物体交互预测 (Short-term Object Interaction Anticipation):在视频片段的最新一帧中检测一组未来可能发生交互的目标物体;为每个物体分配一个表示未来可能发生的交互的动词,并估计交互即将开始的“接触时间”(time to contact)。
- 长程动作预测 (Long-Term Action Anticipation):预测摄像设备穿戴者未来的动作序列。
Ego-Exo4D
Ego-Exo4D 是一个具有多样性的大规模多模态、多视角视频数据集和基准测试集。该数据集的多模态特性是前所未有的:视频中还配有多通道音频、眼动注视轨迹、3D点云、相机姿态、惯性测量单元(IMU)以及多组配对的语言描述——其中包括由教练和教师针对熟练活动领域量身定制的新颖“专家评述”。
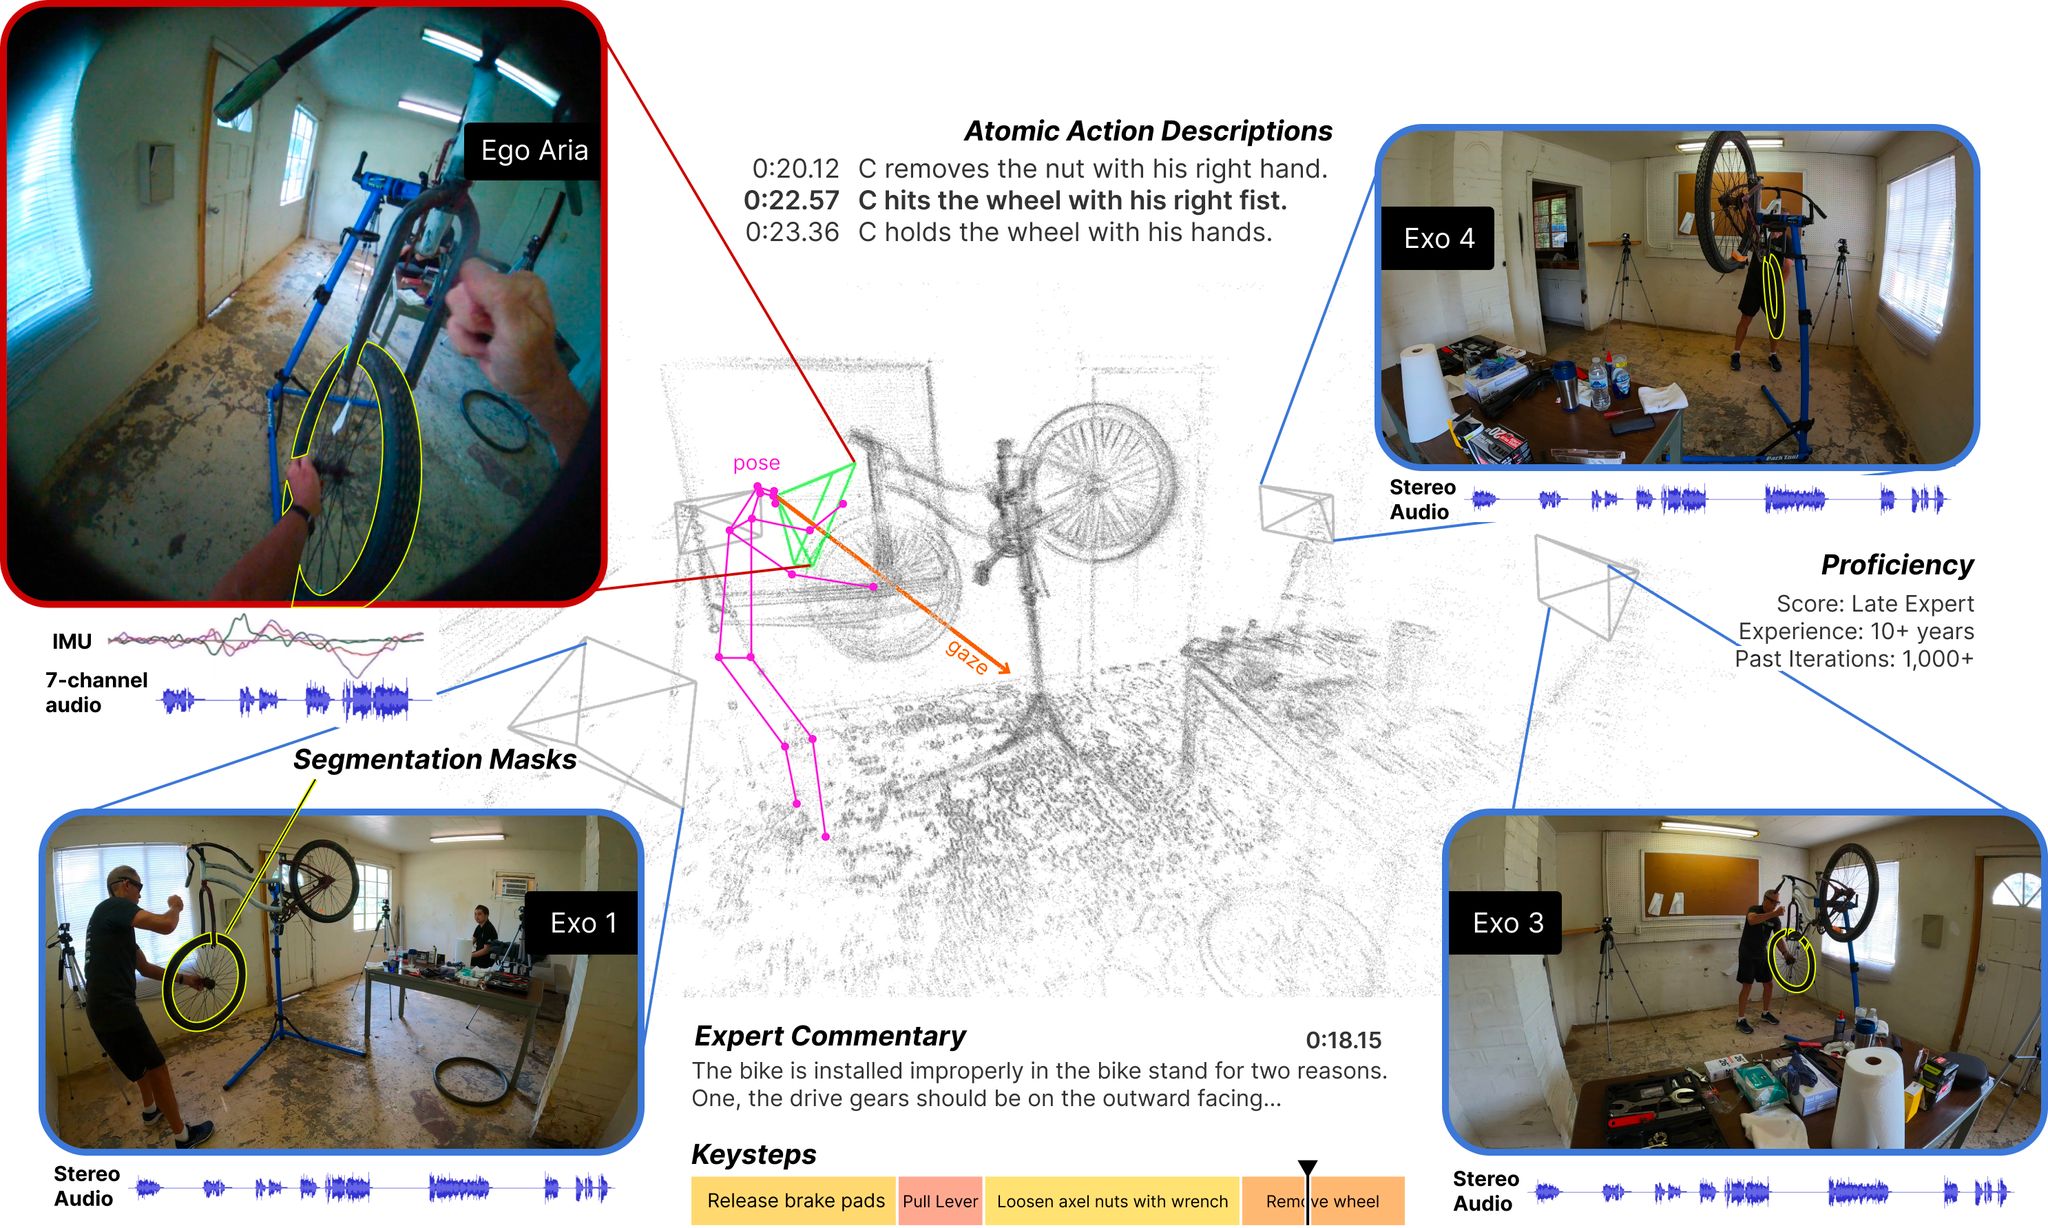
同时随着数据集的推出,Ego-Exo4D 附带了四类基础性的任务、并提供了对应的标注和评估协议用以公平量化社区贡献:
- 自我-他我关联(ego-exo relation):通过估计语义对应关系和转换视角,将教师(他我/exocentric,第三人称视角)的动作与学习者(自我/egocentric,第一人称视角)联系起来。
- 自我(-他我)识别(ego(-exo) recognition):用于识别细粒度的关键步骤和任务结构。
- 自我(-他我)熟练度估计(ego(-exo) proficiency estimation):用于推断一个人执行某项技能的熟练程度。
- 自我姿态(ego pose):用于从第一人称视角视频中恢复娴熟的3D身体和手部动作。我们为每个任务提供相应的标注——这是超过20万小时标注工作的成果。
相比于其它数据集,Ego-Exo4D 具有诸多特色:
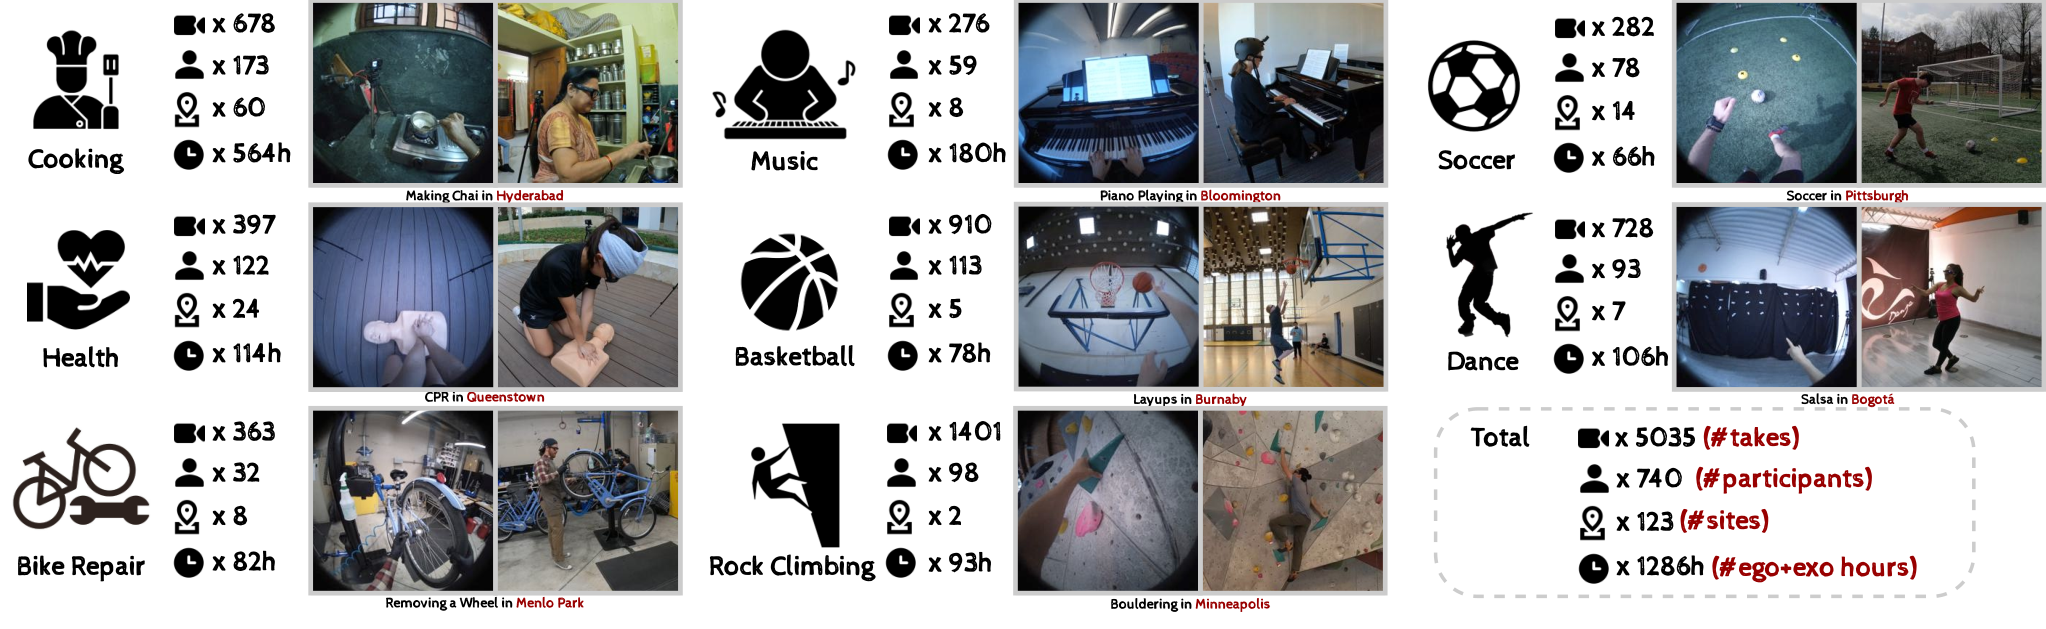
- 规模跨越:覆盖 740 人、123 个场景、1286 小时,体量远超同类数据集。
- 场景真实:打破实验室与家庭限制,扩展至足球场、舞蹈室、维修店等真实户外与专业场地。
- 动作全域:突破桌面局部手部交互,覆盖丰富的全身大幅度动态姿态。
- 双视同步:实现真实复杂环境下第一视角(Ego)与多视角(Exo)的高质量时钟同步。
- 聚焦技能:专门针对具有专业门槛的技能动作(Skilled Activities),填补动作质量评估的空白。
- 三维标注:提供实况旁白、第一视角操作说明与第三视角专家点评三重语言标注。
- 拓宽任务:为大视差下的跨视角对齐、新视角合成与视角关联建模提供了全新的基准。
数据集构建流程
摄像
为了在全球范围内采集 ego-exo(第一视角与第三视角)数据,研究团队开发了一套低成本的摄像录制装备。它具有便携、自动同步、能采集丰富传感器数据且可在国际范围内获得的特点。研究团队的解决方案包括:1 台 Aria(见图 3)、4 台 GoPro、1 个 GoPro 远程控制器、4 个三脚架、4 张 SD 卡、4 个三脚架转接头、4 个带魔术贴的外置电池组、4 条 USB-A 转 USB-C 数据线、1 条眼镜运动绑带、1 部智能手机,以及 1 台用于填写问卷的笔记本电脑或平板电脑。除 Aria、手机和笔记本电脑外,总成本低于 3000 美元。
其中最引人注目的是 Aria (现已开发至第二代)。Aria 设备模拟了未来的增强现实(AR)或智能眼镜,旨在服务于机器感知和第一视角 AI,而非人类内容消费。它被设计为适合长时间佩戴且不会阻碍或妨碍佩戴者,即使在进行足球或舞蹈等高动态活动时,也能保持自然运动。
在 Ego-Exo4D 中,Aria 使用了以下传感器配置:
- 一台滚动快门(Rolling-shutter)RGB 摄像机:以 30 fps 的帧率和 的分辨率录制,视角(FOV)为。
- 两台全局快门(Global-shutter)单色摄像机:以 30 fps 的帧率和 的分辨率录制。它们提供外围视野,每台视角为。
- 两台单色眼动追踪摄像机:以 10 fps 的帧率和 的分辨率录制。
- 一个七麦克风阵列:录制佩戴者周围的空间音频。
- 两个惯性测量单元(IMU):采样率分别为 800 Hz 和 1000 Hz;一个气压计(50 fps)和一个磁力计(10 fps)。
所有传感器流都带有时间戳和每帧曝光时间等元数据。所有数据均作为 Ego-Exo4D 数据集的一部分以原始形式提供。
另外,Project Aria 的机器感知服务(MPS)提供了软件构建块,简化了对录制的不同模态数据的利用。Aria 还包含下述核心功能:
- 校准(Calibration):所有传感器都进行了内参和外参校准。MPS 还提供随时间变化的在线校准,可纠正由于温度变化或施加在眼镜架上的应力所导致的微小形变。
- Aria 6 DoF 定位(Aria 6 DoF localization):利用最先进的 VIO(视觉惯性里程计)和 SLAM(同步定位与建图)算法,将每一次录制精准且鲁棒地定位在一个统一的、以米为单位的、重力对齐的坐标系中。这为每一个捕获的帧提供了毫米级精度的 6 DoF(六自由度)位姿,以及相机帧之间的高频(1 kHz)运动数据。
- 眼动视线(Eye gaze):用户的视线方向被估计为一条以佩戴者双眼之间为锚点的向外射线。我们使用了一种可选的眼动视线校准程序:移动端的配套 App 会引导佩戴者在进行特定头部运动的同时,注视手机屏幕上的特定图案。这些信息随后被用来生成个性化且更精准的眼动视线方向。
- 点云(Point clouds):通过移动的 Aria 设备,利用连续帧或左/右 SLAM 相机之间的光度立体(Photometric stereo)技术,三角化出静态场景元素的 3D 点云。输出既包含 3D 点云,也包含在相机图像中因果计算出的每个点的原始 2D 观测数据。
- GoPro 6 DoF 定位(GoPro 6 DoF localization):对于 Ego-Exo4D,我们还在现有的 Aria MPS 功能之上构建了额外功能,专门用来定位静态的 GoPro 相机。为了实现这一点,我们利用 Aria 的 SLAM 相机构建的地图,并在该地图上对 GoPro 帧进行 6 DoF 定位。为了获取 GoPro 的校准参数,我们在实验室手动校准了一台设备以获取默认参数,随后使用 P4P 算法(配合 RANSAC 以剔除匹配异常值)来估计 6 DoF 位姿,并重新估计焦距,以弥补不同设备间可能存在的校准差异。
录制流程
项目的录制流程为:
- 将静态的 GoPro 安装在三脚架上(放置位置在各个场景中大体保持一致)
- 戴着 Aria 在场地内走动一圈(Walk-around),以构建用于 3D 重建和相机定位的底图(Basemap)
- 在开始/结束时展示 QR 码以辅助时间同步
- 在每个 Take(镜头)之间展示“镜头分隔 QR 码”
对于某些特定场地,摄像机装备还使用了额外的支架和 GoPro 进行扩展。具体而言,为了同步所有相机,研究团队使用了一段预先渲染好的 QR 码序列(即 QR 码视频),其中编码了墙上时钟时间(真实时间)。研究团队使用智能手机以 29 fps 的帧率向所有相机依次展示这段 QR 码视频,并利用帧率差异对相机进行精细同步。随后的手动验证环节确保了每台 GoPro 相机与 Aria RGB 相机的时间误差在 1 帧以内()。为了分摊每次录制所需的设置和拆卸时间,研究团队连续录制多个“Take”(即某项任务的一次执行过程),并在后期处理中使用“Take 分隔符”QR 码将不同的 Take 进行区分。
数据集构成
Ego-Exo4D 作为面向有技巧性活动的数据集,精选了体育类和过程类两类范畴八个领域共 43 项活动,涵盖烹饪、健康、音乐、舞蹈等不同的领域。
自然语言描述 (Natural Language Descriptions)
Ego-Exo4D 提供了三种经过和视频时序对齐的自然语言配对数据:专家评述、自然叙述与动作、以及原子化的动作描述。
专家评述 (Expert Commentary)
专家评述的目标是对一些非专家不太清楚的技能进行进一步揭示。研究团队招募了 52 名专家,分析视频记录中的优势和缺陷,解释视频拍摄者的行为如何影响表现,并提供了相应的空间标记以支撑专家的评价。
专家会被提供两段视频,一段是第一人称视角的视频,另一段是某一个角度的第三人称视角视频。专家首先会被要求完整观看一次视频,从而理解视频对应的技能阐释并规划好评论要点;然后再进行第二次视频观看,并在需要评论时随时暂停,进行评价。
专家被鼓励聚焦于规范并给出教学建议,而不是只描述视频中的人在做什么。研究团队则记录专家们给出的评价中涉及到摄像设备穿戴者动作、行为质量的积极或消极评价和错误反馈。另外,所有的专家评论均带有时间锚点且具有回顾性,侧重于针对视频中截至该时间点所展现动作的洞见与视角。此外,专家还会提供空间标注,用于增强和佐证评论,并从一到十提供熟练度打分。
为了保持动作表现描述的自然性并快速完成采集,研究团队选择以语音录音的形式收集解说。每段口述解说的长度不设限制,平均包含 4 个句子。
自然叙述与动作 (Narrate and Act)
自然叙述与动作部分由摄像设备穿戴者自己提供。摄像设备穿戴者以“教程”或“how-to”式视频的方式,描述自己在做什么以及为什么这么做。
通常来说,专家解说在有关活动质量的建设性反馈方面更为丰富;而“边做边说”(narrate-and-act)式的旁白之所以引人关注,则在于其即时同步性以及对参与者自身行为的第一人称剖析。在这一额外录制版本(extra take)中,行为表现预计会与无旁白任务有所不同,因为参与者很可能会为了专注于解释自己的操作,而比平时更慢地完成该场景任务。在 Ego-Exo4D 数据集中,大约 10% 的录制片段提供了此类旁白,因为研究团队希望参与者在绝大多数录制过程中无需停顿地执行任务。
原子化的动作描述 (Atomic Action Descriptions)
Ego-Exo4D 数据集的语言标注由旁白描述、可见性标签以及三种文本形式的对比组成。在旁白描述方面,标注员基于集成了第一人称、双侧 SLAM、4至5个固定第三人称及复合音频的拼接视频进行逐场逐句的详细记录。每条旁白均具备原子性并绑定时间戳,通常仅含单一动词且误差在一秒内;视频中的摄像机佩戴者统一代称为“C”,其余人则以字母区分,多数视频提供两份独立标注。
为了解决现有单视角系统在多镜头下因视线受阻导致模型信号混乱或无法推断的问题,数据集引入了可见性标签。标注员需要明确回答第一人称视角是否可见,以及哪台第三人称相机提供了最佳视角,这一标注已成功辅助多项后续任务的视角选择与姿态估计帧筛选。
对比三种语言标注可以发现,专家解说因包含详尽的建议与解释而词汇量最大、语句最长。原子动作描述则因逐一记录了佩戴者的所有动作,在三者中时间密度最高。“边做边说”旁白的词汇量居中,表现出更自由的口语化特征。在不同场景中,烹饪因工序繁多、足球因训练动作密集,两者的标注时间密度显著高于其他场景。
基准研究任务 (Ego-Exo4D Benchmark Tasks)
伴随着数据集,Ego-Exo4D 定义了四个基准研究任务族——关联、识别、熟练度和第一人称姿态。
对于每一类任务,研究团队都提供了高质量的多模态数据集和标注,用于训练和评估模型。
| 基准测试 (Benchmark) | 标注类型 (Annotation Type) | Ego-Exo4D (v2) 视频片段数 | 规模与类别 (Num Takes / Classes) | 标注详情 (Annotations) |
|---|---|---|---|---|
| 关联性分析 (Relations) | 人工标注 (Manual) | 1335 | 5566 | 目标物体 74.2万个第一人称视角掩膜 (ego masks) 110万个第三人称视角掩膜 (exo masks) |
| 关键步骤识别 (Keystep recognition) | 人工标注 (Manual) | 1088 | 17种活动, 664个关键步骤 | 2.76万个第一人称视角片段 (87小时) 14.3万个第一与第三人称综合视角片段 (454小时) |
| 流程理解 (Procedure understanding) | 人工标注 (Manual) | 628 | 6种活动, 186个关键步骤 | 8600个片段 (30小时) |
| 熟练度评估 (Proficiency estimation) | 半自动标注 (Semi-automatic) | 2987 | - | 2987个演示者熟练度评分 |
| 人工标注 (Manual) | 912 | - | 1.9万个“优秀操作”片段 2万个“技巧提示”片段(教学演示) | |
| 主视角人体姿态估计 (Ego pose - Body) | 自动标注 (Automatic) | 2559 | - | 920万个3D姿态 / 4687万个2D姿态 |
| 人工标注 (Manual) | 1358 | - | 37.6万个3D姿态 / 200万个2D姿态 | |
| 主视角手部姿态估计 (Ego pose - Hand) | 自动标注 (Automatic) | 976 | - | 430万个3D姿态 / 2100万个2D姿态 |
| 人工标注 (Manual) | 458 | - | 6.8万个3D姿态 / 34万个2D姿态 |
第一人称-第三人称关联 (Ego-Exo Relation)
第一人称-第三人称关联任务致力于关联跨越极度视角变化的视频内容。这些任务主要表现为物体级匹配(对应性,Correspondence)以及从一个视角合成另一个视角(生成转换,Translation)。
Ego-Exo 物体对应性 (Ego-Exo Correspondence)
任务定义:给定一对时间同步的 Ego-Exo 视频以及其中一个视频中目标物体的查询掩码(Query Mask)序列,该任务的目标是在另一个视角的每个同步帧中识别出同一物体的对应掩码。
针对该基准,研究团队在评估中采用以下指标:
- 位置误差 (Location Error, LE):定义为预测掩码的形心(Centroid)与真实掩码(GT)形心之间的归一化距离。
- 交并比 (Intersection Over Union, IoU):预测掩码与真实掩码之间的交并比。
- 轮廓准确率 (Contour Accuracy, CA):测量在平移对齐预测掩码与真实掩码的形心后的掩码形状相似度。
- 可见性准确率 (Visibility Accuracy, VA):评估模型判断目标物体在目标视角中是否可见的能力,以处理物体被遮挡或位于视野之外等情况。研究团队采用平衡准确率(Balanced Accuracy)进行计算。与前三项指标仅在物体于两个视角中均可见的帧上计算不同,VA 基于所有包含查询掩码的帧进行评估。
Ego-Exo 视角转换 (Ego-Exo Translation)
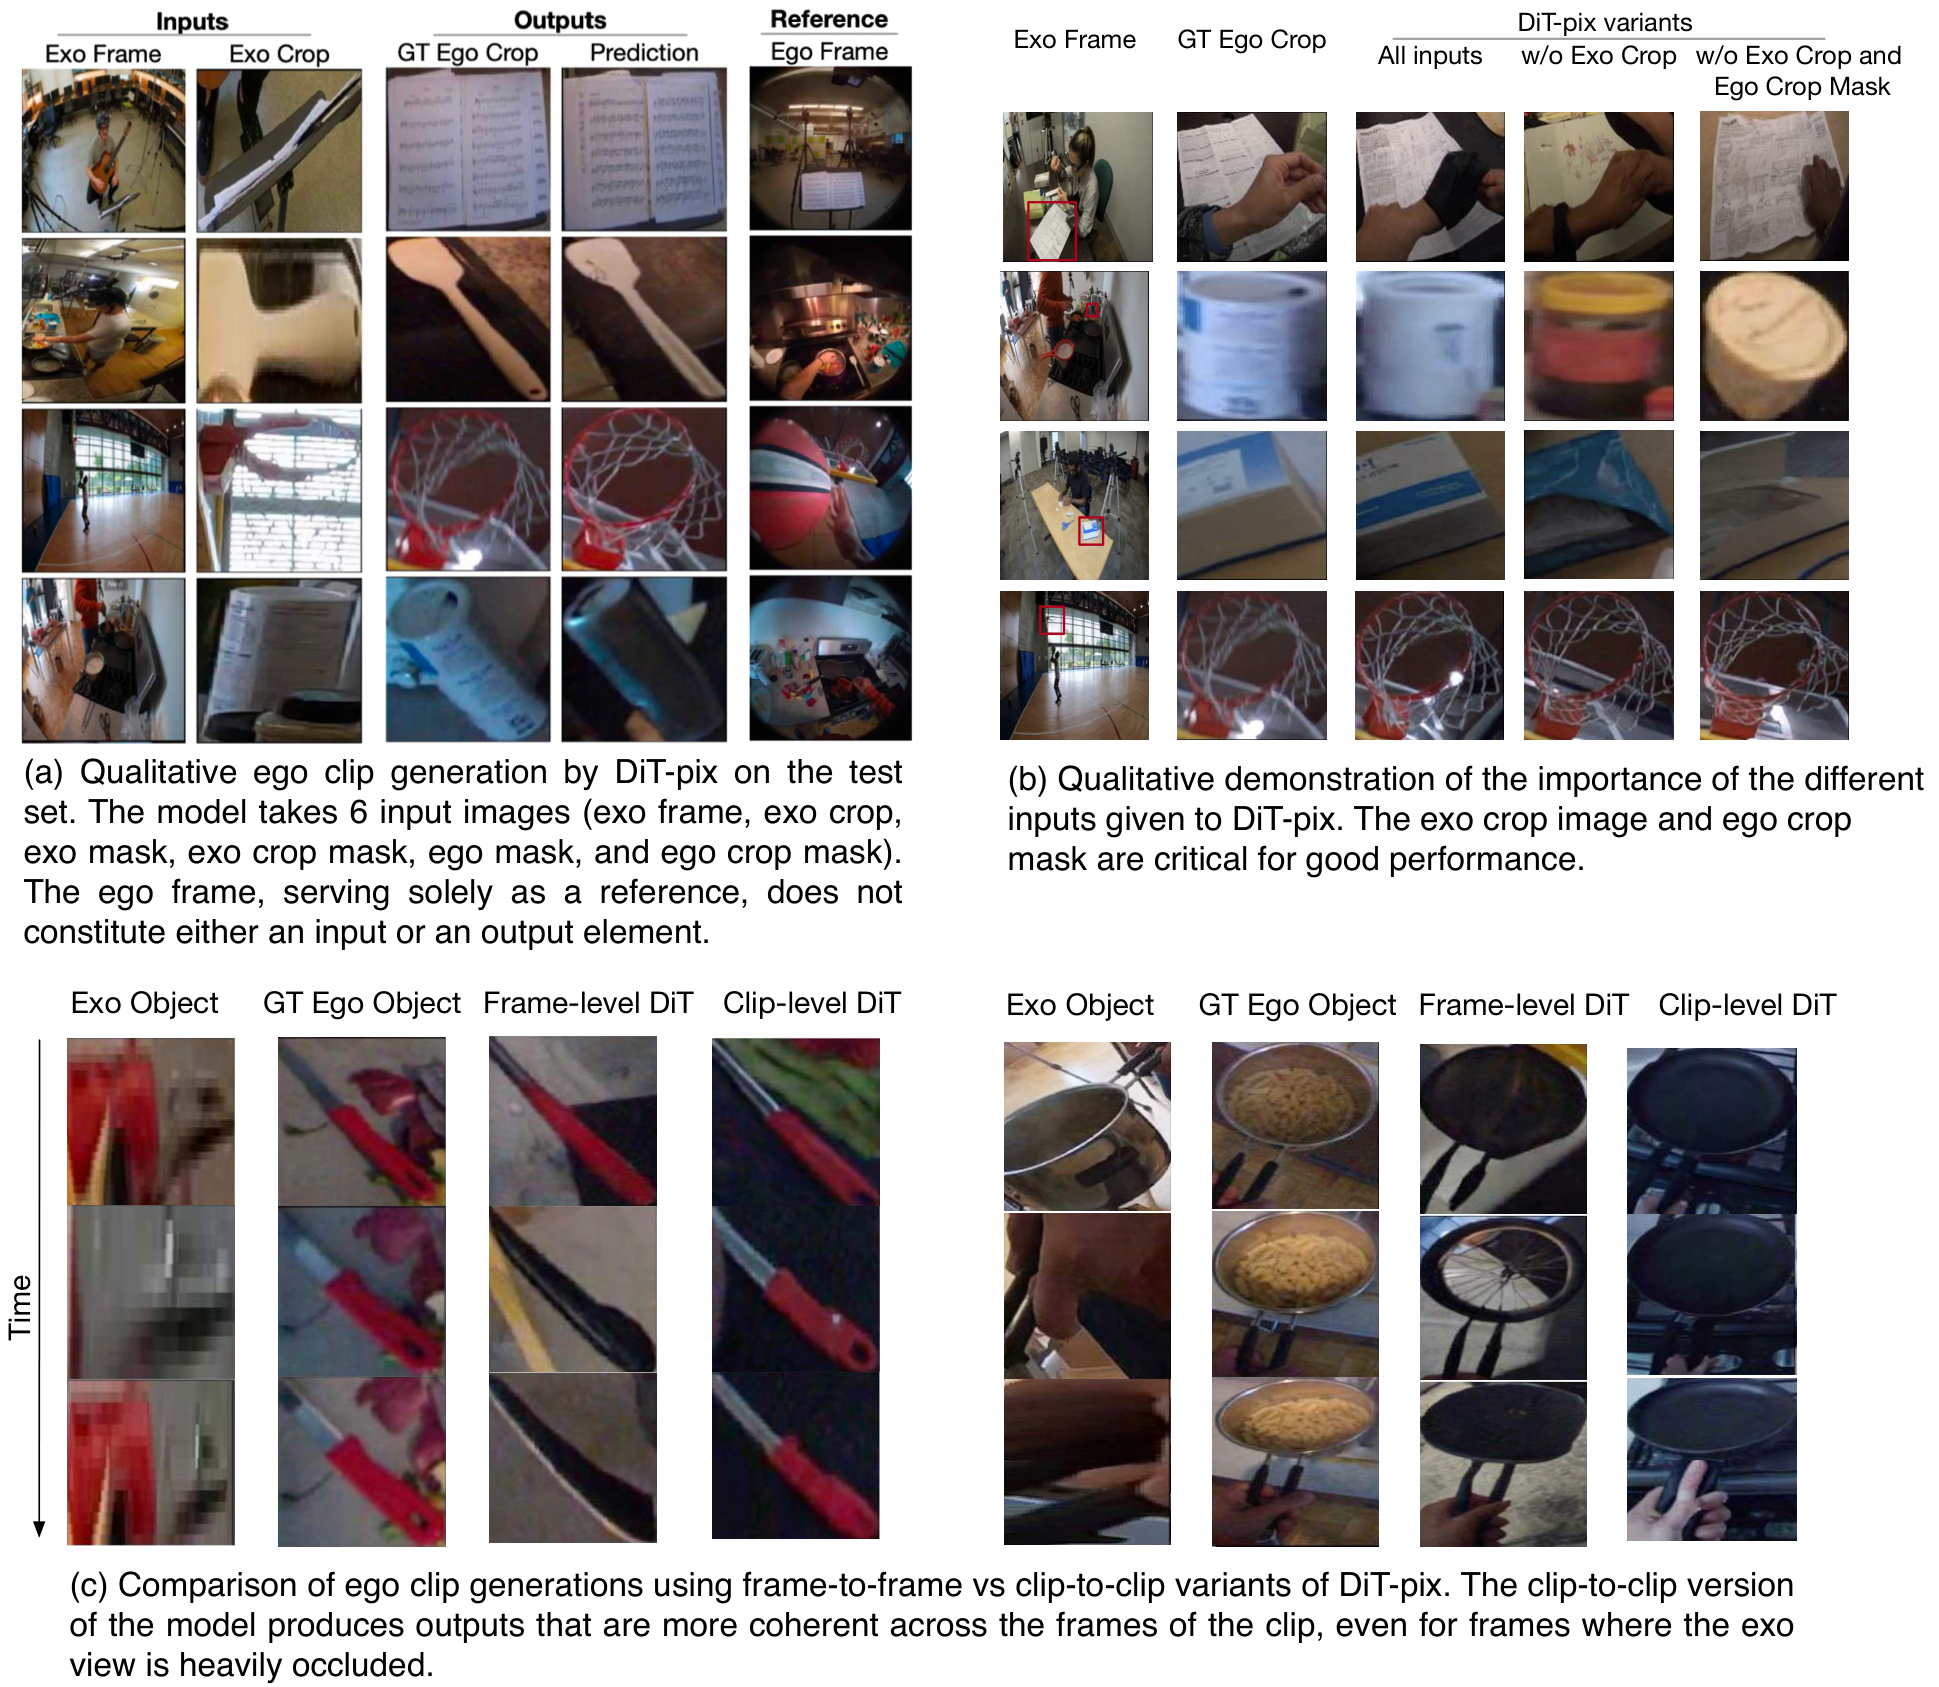
任务定义:给定 Exo 视频及其中目标物体的分割掩码,生成对应但未被观测到的 Ego 视角信息。该任务由两个子任务组成:
- Ego 轨迹预测 (Ego Track Prediction):根据已观测 Exo 视频中的目标物体掩码,预测该物体在未观测 Ego 视频中的位置与分割掩码。
- Ego 视频生成 (Ego Clip Generation):在给定真实 Ego 目标掩码的条件下,根据 Exo 视频及其中的目标物体信息,生成目标物体在 Ego 视角中的 RGB 外观。
对于两个子任务,输入均为从 5 秒时间范围内均匀采样得到的 5 帧 Exo 视频。基准还提供允许模型在推理阶段使用 Ego 相机相对于 Exo 相机位姿的变体。
针对Ego 轨迹预测,研究团队采用以下指标:
- 可见性准确率 (Visibility Accuracy, VA):评估模型根据 Exo 视频判断目标物体在 Ego 视角中是否可见的能力。当物体不可见且预测掩码为空,或物体可见且预测掩码非空时,视为预测正确。
- 位置误差 (Location Error, LE):衡量预测掩码与真实 Ego 掩码之间的位置偏差。
- 交并比 (Intersection Over Union, IoU):衡量预测掩码与真实 Ego 掩码之间的区域重合程度。
- 轮廓准确率 (Contour Accuracy, CA):衡量预测掩码与真实 Ego 掩码之间的轮廓形状相似度。IoU 与 CA 均在预测掩码和真实掩码的形心对齐后计算,以尽量排除位置误差的影响。
针对Ego 视频生成,研究团队采用以下指标:
- 结构相似性 (Structural Similarity Index Measure, SSIM):衡量生成图像与真实图像在亮度、对比度和结构上的相似程度。
- 峰值信噪比 (Peak Signal-to-Noise Ratio, PSNR):衡量生成图像相对于真实图像的像素级重建质量。
- 深度图像结构与纹理相似度 (Deep Image Structure and Texture Similarity, DISTS):从深度特征层面衡量生成图像与真实图像之间的结构和纹理差异。
- 学习感知图像块相似度 (Learned Perceptual Image Patch Similarity, LPIPS):利用深度网络特征衡量生成图像与真实图像之间的感知差异。
- CLIP 相似度 (CLIP Similarity):利用 CLIP 特征衡量生成图像与真实图像在高层语义上的相似程度。
第一人称-第三人称关键步骤识别 (Ego-Exo Keystep Recognition)
第一人称-第三人称关键步骤识别任务聚焦于程序性活动中的关键步骤(Keystep)识别及其依赖关系建模。该任务族包含细粒度关键步骤识别、能效多模态关键步骤识别和程序理解三个任务。部分任务在训练阶段可以利用 Exo 视角信息,但推理阶段主要面向 Ego 视角。
细粒度关键步骤识别 (Fine-Grained Keystep Recognition)
任务定义:给定经过裁剪、仅包含某一关键步骤的视频片段,模型需要识别当前正在执行的具体关键步骤类别。训练阶段可以同时利用带标签的 Ego-Exo 视频片段,而测试阶段仅提供 Ego 视角 RGB 视频,模型需要据此预测对应的关键步骤标签。
该任务不同于一般的粗粒度动作识别。同一活动中的不同关键步骤可能涉及相同物体,仅在手部动作、物体状态或交互方式上存在细微差异,同时不同关键步骤的持续时间也可能存在较大差异。
针对该基准,研究团队采用以下指标:
- Top-1 准确率 (Top-1 Accuracy):统计模型最高置信度预测类别与真实关键步骤类别一致的样本比例。
- 由于数据中的关键步骤呈明显长尾分布,评估仅纳入至少包含 20 个样本的关键步骤类别,共计 278 个类别。
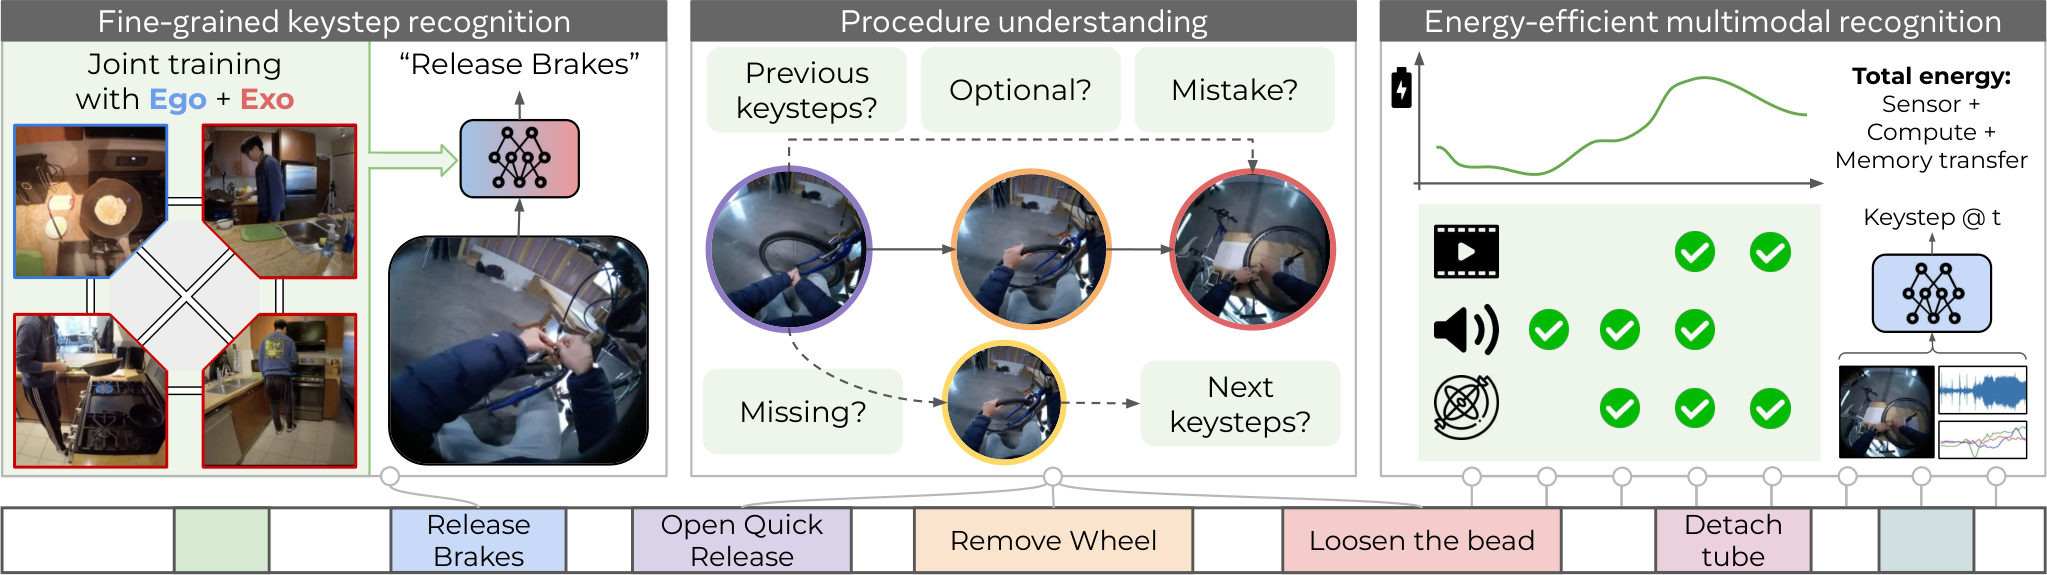
能效多模态关键步骤识别 (Energy-Efficient Multimodal Keystep Recognition)
任务定义:给定持续输入的第一人称多模态视频流以及限定的能耗预算,模型需要在线识别当前正在执行的关键步骤,同时保证传感器采样与模型推理产生的总能耗不超过预算。
模型由两个核心部分构成:
- 传感器触发策略 (Sensor Triggering Policy):在每个时间步决定需要激活并采样哪些传感器模态,例如 RGB、音频或 IMU。
- 关键步骤预测模型 (Keystep Prediction Model):根据当前已经获取的多模态观测信息预测当前关键步骤。
该任务属于严格的在线识别任务,因此模型在任意时间点只能使用当前及历史观测信息,不能访问未来数据。
针对该基准,研究团队采用以下指标:
- 逐帧校准平均精度均值 (Mean Calibrated Average Precision, mcAP):衡量在线关键步骤识别性能,并通过校准机制减小关键步骤类别不平衡带来的影响。
- 功耗 (Power Consumption):以毫瓦(mW)为单位衡量系统运行产生的总功耗,综合考虑模型计算、内存数据传输以及传感器运行三部分开销。
根据允许的功耗预算,基准进一步划分为两个等级:
- 高能效等级 (High-Efficiency Tier):功耗预算为 20 mW。
- 高性能等级 (High-Performance Tier):功耗预算约为 2.8 W。
因此,该任务并非单独追求最高识别性能,而是同时评价模型在识别性能与能源消耗之间的权衡。
程序理解 (Procedure Understanding)
任务定义:给定当前关键步骤的视频片段以及此前已经观察到的步骤历史,模型需要推断程序活动背后的结构关系,并判断当前步骤在整个程序中的状态。
模型需要完成以下五类预测:
- 前置关键步骤 (Previous Keysteps):判断原则上应当在当前步骤之前完成的关键步骤。
- 可选步骤 (Optional Keystep):判断当前步骤是否可以被省略而不影响程序的正确完成。
- 程序错误 (Procedural Mistake):判断当前步骤是否因必要前置条件尚未满足而属于错误执行。
- 缺失关键步骤 (Missing Keysteps):识别当前历史中本应已经完成但实际缺失的前置步骤。
- 后续关键步骤 (Next Keysteps):预测当前依赖条件已经满足、接下来可以执行的关键步骤。
该任务包含两种弱监督设置:
- 实例级监督 (Instance-Level Supervision):训练和推理阶段均提供视频片段及其关键步骤标签。
- 程序级监督 (Procedure-Level Supervision):训练和推理阶段仅提供未标注的视频片段以及该程序对应的关键步骤名称体系,不提供片段级关键步骤标签。
无论采用哪种监督设置,模型都必须按照因果方式处理视频,即当前时刻的预测只能依赖此前已经观察到的信息。
针对该基准,研究团队采用以下指标:
- 校准平均精度 (Calibrated Average Precision, cAP):将不同类型的关键步骤集合预测视为检测问题,衡量模型对前置步骤、可选步骤、程序错误、缺失步骤和后续步骤的预测性能,并针对正负样本数量不平衡进行校准。
- 在该评价指标下,随机预测的期望性能约为50%。
第一人称-第三人称熟练度估计 (Ego-Exo Proficiency Estimation)
第一人称-第三人称熟练度估计任务不再仅判断执行者正在“做什么”,而进一步判断其任务执行水平“做得怎么样”。该任务族同时关注执行者整体技能水平以及单次任务演示中的局部执行质量,并可利用 Ego 与 Exo 视角提供的互补信息。
执行者熟练度估计 (Demonstrator Proficiency Estimation)
任务定义:给定同一执行者的一个或多个任务演示视频,根据 Ego 视频以及可选的时间同步 Exo 视频,预测该执行者的整体技能水平。
任务被建模为四分类视频分类问题,包含以下等级:
- 新手 (Novice)
- 初级专家 (Early Expert)
- 中级专家 (Intermediate Expert)
- 高级专家 (Late Expert)
Ego 视频更容易捕获手部姿态和人与物体之间的细粒度交互,而 Exo 视频能够提供更完整的全身姿态与整体动作信息,因此两个视角对于不同类型的技能具有互补价值。
针对该基准,研究团队采用以下指标:
- Top-1 准确率 (Top-1 Accuracy):统计模型预测的熟练度等级与真实熟练度标签一致的样本比例。
单次演示熟练度估计 (Demonstration Proficiency Estimation)
任务定义:给定一次完整的任务演示视频,模型需要在时间轴上定位能够体现执行质量的具体时刻,并判断这些时刻属于执行良好 (Good Execution) 还是需要改进 (Needs Improvement)。对于无法体现执行者技能水平的视频部分不进行标注。
因此,该任务本质上属于时间定位任务,其输出为两类时间戳集合:执行良好时刻以及需要改进的时刻。
针对该基准,研究团队采用以下指标:
- 平均精度均值 (Mean Average Precision, mAP):衡量模型定位“执行良好”和“需要改进”时刻的能力。
- 与传统时间动作定位任务通常使用时间交并比(Temporal IoU)比较时间段不同,该任务使用预测时间戳与真实时间戳之间的L1 时间距离判断预测是否正确。
- 基准分别在不同的时间距离阈值下计算 mAP,以衡量预测时刻与真实标注时刻之间的定位精度。
第一人称姿态估计 (Ego Pose)
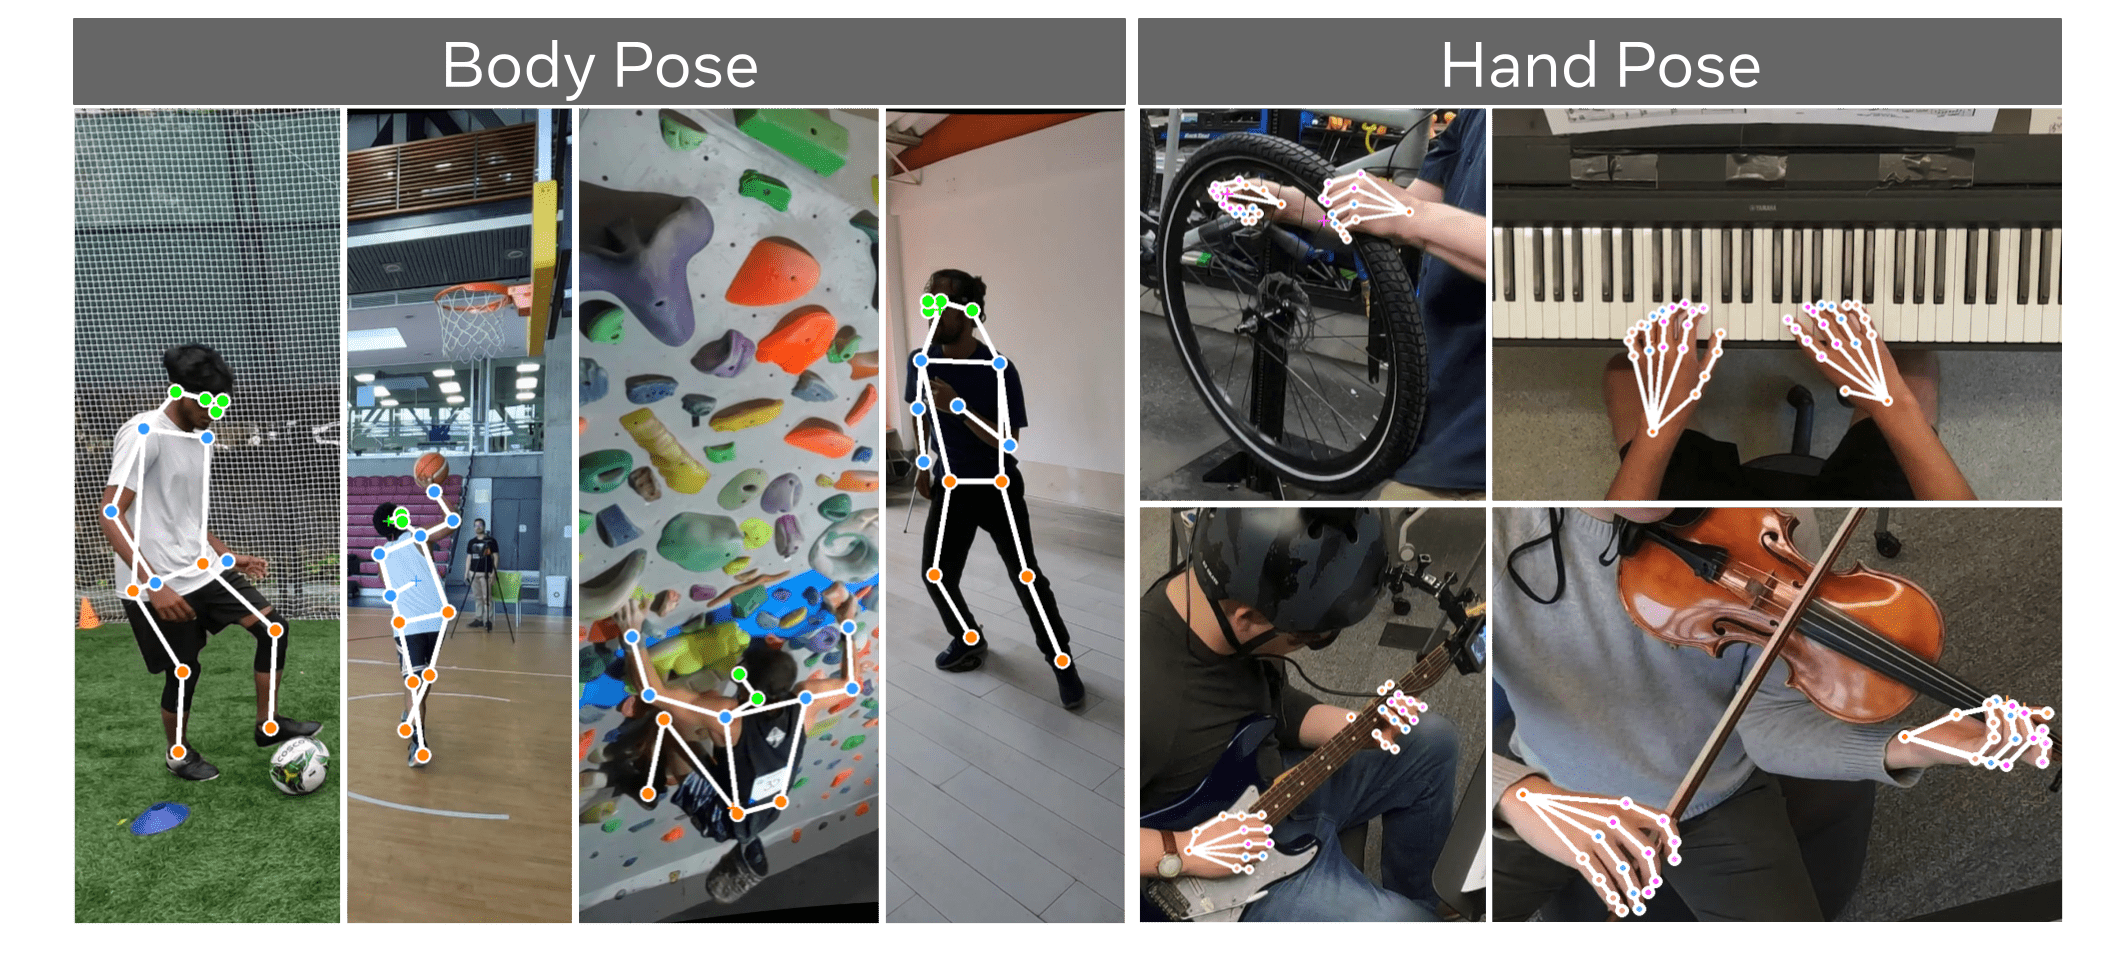
第一人称姿态估计任务旨在从第一人称视角恢复相机佩戴者的三维身体状态,重点关注真实动态环境中的人体和手部运动。该任务族包含身体姿态估计与手部姿态估计两个任务,需要处理频繁遮挡、身体部位位于视野之外以及复杂细粒度运动等问题。
身体姿态估计 (Body Pose Estimation)
任务定义:给定 Ego RGB 视频序列、IMU 传感器序列或两者的组合,模型需要估计相机佩戴者连续时间内的三维人体姿态序列。每一帧人体姿态由遵循 MS COCO 定义的17 个三维人体关节点表示。
测试阶段仅在当前帧中具有有效标注的可见关节点上计算预测误差。该任务不使用 Exo 视频、音频、眼动等能够额外简化问题的信息。
针对该基准,研究团队采用以下指标:
- 平均关节位置误差 (Mean Per Joint Position Error, MPJPE):计算预测三维关节位置与真实关节位置之间的平均距离,用于衡量空间姿态估计精度,单位为厘米(cm)。
- 平均关节速度误差 (Mean Per Joint Velocity Error, MPJVE):计算预测关节运动速度与真实关节运动速度之间的平均误差,用于衡量姿态序列的运动与时间一致性,单位为米每秒(m/s)。
手部姿态估计 (Hand Pose Estimation)
任务定义:给定单帧 Ego RGB 图像,模型需要预测相机佩戴者至少部分可见手部的三维关节点位置。每只手由遵循 MS COCO 定义的21 个三维手部关节点表示。
该任务直接面向第一人称单目图像中的三维手部重建,需要处理手与物体交互造成的严重遮挡、手指细粒度运动以及部分关节点不可见等问题。
针对该基准,研究团队采用以下指标:
- 平均关节位置误差 (Mean Per Joint Position Error, MPJPE):计算预测三维手部关节位置与真实关节位置之间的绝对平均距离,单位为毫米(mm)。
- Procrustes 对齐平均关节位置误差 (Procrustes-Aligned Mean Per Joint Position Error, PA-MPJPE):首先通过 Procrustes Alignment 对预测手部姿态与真实姿态进行对齐,再计算平均三维关节位置误差,从而更集中地衡量手部姿态结构本身的预测准确程度,单位为毫米(mm)。
回头来看 EPIC-KITCHENS-100、Ego4D 和 Ego-Exo4D,可以发现视频数据集的发展并不只是简单地追求“更多小时的视频”。
EPIC-KITCHENS-100 展示了一条相对完整而直观的基础流程:先记录真实活动,再通过参与者叙述、人工转录、语义解析、时间切分和空间标注,把连续视频转换为动作、物体和时间边界等结构化监督信号。
Ego4D 将这套思路推向更大的开放世界。数据采集不再局限于单一场景,而是覆盖大量参与者、地域、职业和日常活动;与此同时,密集自然语言叙述成为连接原始视频与下游任务的重要中间层。研究者不需要一开始就为每一种任务从零标完整数据,而是先建立一层相对通用的视频语义描述,再从中筛选和派生情节记忆、手物交互、社交理解和未来预测等不同基准。
到了 Ego-Exo4D,视频数据又进一步从“单一视频流”扩展成了一个同步的多模态观测系统:第一人称视频、多个第三人称视角、音频、IMU、眼动、相机位姿、点云、自然语言描述和专家评价被共同放进统一的时间与空间坐标中。此时所谓的“数据集”已经不再只是若干视频文件,而更接近于对真实人类活动的一次结构化数字化记录。
因此,从 Raw Video 到 Corpus,可以把整个过程概括为一条逐层增加结构的链路:
现实活动 → 多源采集 → 时间同步与空间校准 → 原始视频 → 语言与事件描述 → 时间/空间/对象/姿态等标注 → 结构化样本 → Benchmark 与训练任务 → 可训练数据集。
真正值得注意的是,同一批原始视频可以被不断重新解释。
今天它可以被标成“切番茄”这样的动作分类数据;明天可以进一步标记手、刀和番茄之间的交互;再之后,可以恢复三维手部轨迹、判断物体状态变化、建立 Ego-Exo 对应关系,甚至评价动作执行得是否熟练。原始视频本身没有改变,变化的是我们从视频中提取和组织监督信号的方式。
这也正是“数据飞轮”真正开始转动的地方。
数据并不是一次性制作完成的静态资产。随着模型能力增强,我们可以从旧视频中提取新的标签、新的结构和新的任务;新的模型又可以参与下一轮自动标注、筛选和质量控制,使原本依赖大量人工完成的数据生产过程逐渐自动化。
所以,RawVideo2Corpus 讨论的不是怎样“收集一批视频”,而是怎样把现实世界的连续经验,逐步加工成机器能够学习的结构化知识。
而接下来真正有意思的问题,就是:当这个过程不再主要依赖人工时,能不能让模型自己参与到数据的理解、清洗、标注、筛选和再生产之中,让这条链路最终形成一个能够持续自我增强的数据飞轮。