AVID: Automated Visual Instruction-Following with Demonstrations (自动化视觉指令遵循法)
机器人可以通过多阶段学习掌握复杂任务,但是任务分解和设置各阶段奖励却非常困难。虽然可以使用模仿学习来解决这个困难,但是该过程往往需要手动引导或进行远程操作,且非常繁琐。
因此,可以尝试使用人类示范视频,利用这些示范视频来提供自然的、详细的指导,从而让机器人能够借助任务的阶段性特征来有效学习。
本文则提出一种方法:
首先,构建人类示范。
然后,借助 CycleGAN 框架,在像素级别将人类的示范转化为机器人执行任务的图像。
在处理多阶段任务时,人类的示范被简化为几张指示图片,代表了任务的各个阶段。
这些指示图片通过 CycleGAN 进行转换,然后将其作为基于模型的强化学习的奖励,从而让机器人能够反复练习这项技能,进而掌握其物理执行能力。
这种方法被命名为“自动化视觉指令遵循法” (AVID)。
学习预备阶段
该部分包括:将人类的行为转化为可处理的格式,对机器人的图像和行为进行建模。
无监督的图像到图像转换
人机演示翻译问题可以看作无监督的图像到图像翻译问题,目标是在没有成对数据的情况下、将源域中的图像映射到目标域。
这里,假设一个可以在无监督形式下被发现的双射映射,目标是学习两个映射框架:G : X → Y G: \ X \to Y G : X → Y F : Y → X F: \ Y \to X F : Y → X D Y D_Y D Y D X D_X D X
L ( G , D Y ) = E [ log D Y ( y ) + log ( 1 − D Y ( G ( x ) ) ) ] \mathcal{L}(G,D_Y)=\mathbb{E}[\log D_Y(y)+ \log (1-D_Y(G(x)))] L ( G , D Y ) = E [ log D Y ( y ) + log ( 1 − D Y ( G ( x )))]
对F F F D X D_{X} D X
此外,需要引入额外的损失项,促进G G G F F F
L c y c ( G , F ) = E [ ∣ ∣ x − F ( G ( x ) ) ∣ ∣ 1 + ∣ ∣ y − G ( F ( y ) ) ∣ ∣ 1 ] \mathcal{L}_{cyc}(G,F)=\mathbb{E}[|| x-F(G(x))||_1 + || y-G(F(y))||_1] L cy c ( G , F ) = E [ ∣∣ x − F ( G ( x )) ∣ ∣ 1 + ∣∣ y − G ( F ( y )) ∣ ∣ 1 ]
进而得到 CycleGAN 的整体训练目标:
L C G ( G , F , D X , D Y ) = L G A N ( G , D Y ) + L G A N ( F , D X ) + λ L c y c ( G , F ) \mathcal{L}_{CG}(G,F,D_X,D_Y)=\mathcal{L}_{GAN}(G,D_Y)+\mathcal{L}_{GAN}(F,D_X)+\lambda \mathcal{L}_{cyc}(G,F) L C G ( G , F , D X , D Y ) = L G A N ( G , D Y ) + L G A N ( F , D X ) + λ L cy c ( G , F )
该部分使用 CycleGAN,将人类演示视频翻译为机器人演示视频。
结构化表示学习 (Structured Representation Learning)
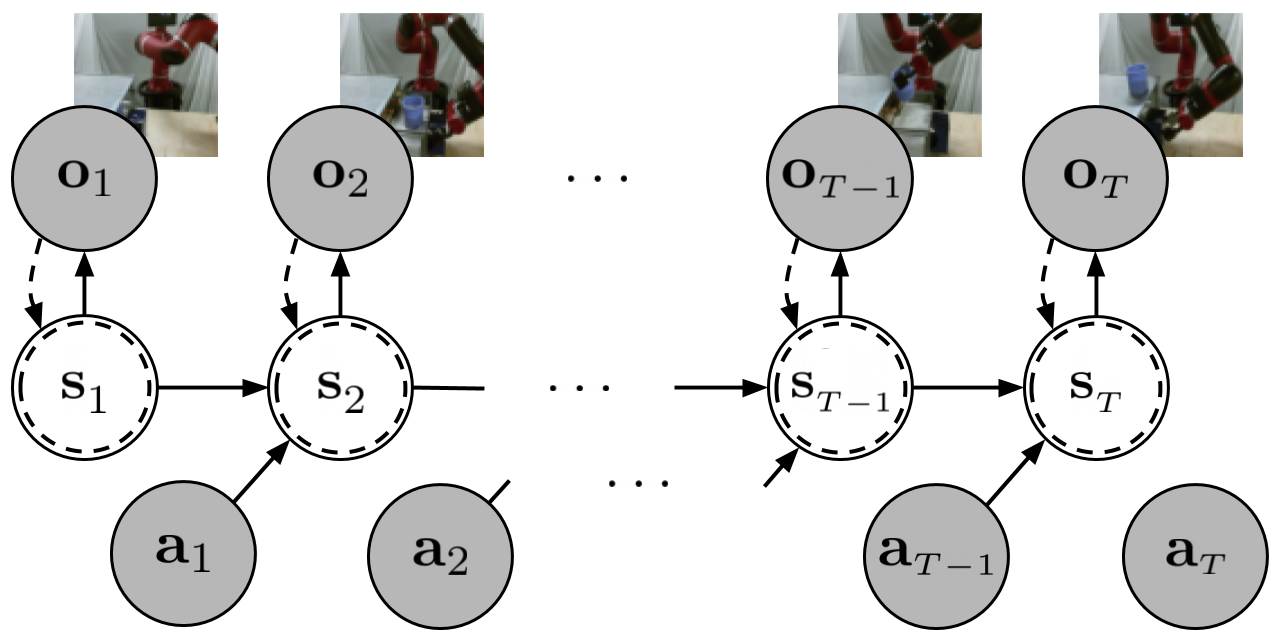
在基于图像的控制学习中,状态表示学习是一种提高数据利用效率的有效方法,通过定义一个概率性的、具有时间结构的潜在变量模型来学习图像观测到的潜在状态表示。
首先定义:
原始图像o t o_t o t :RGB 摄像机拍到的图片,图片里包含很多无用细节(如墙壁颜色、背景光照等)。潜在状态s t s_t s t :机器人的核心物理特征(比如:门把手的角度、机械臂末端的位置,可能只需要少数几个数字就能描述)。
直接用像素级图像去算机器人下一步该怎么走,计算量太大且极其笨拙,因此状态表示学习要做的就是:
压缩 :把庞大的图像o t o_t o t s t s_t s t 预测(动态模型) :在低维的s t s_t s t a t a_t a t s t + 1 s_{t+1} s t + 1 解码 :重构网络。把低维向量s t s_t s t o t o_t o t s t s_t s t
在该过程中,首先加假设初始的低维状态假设符合标准正态分布:
p ( s 1 ) = N ( s 1 ; 0 , I ) p(s_1)=\mathcal{N}(s_{1};\mathbf{0},\mathbf{I}) p ( s 1 ) = N ( s 1 ; 0 , I )
进一步构建系统动态模型,计算转移概率。该过程给定现在的状态s t s_t s t a t a_t a t μ \mu μ Σ \Sigma Σ s t + 1 s_{t+1} s t + 1
p ( s 1 ) = N ( s t + 1 ; μ ( s t , a t ) , Σ ( s t , a t ) ) p(s_1)=\mathcal{N}(s_{t+1};\mu (s_t,a_t),\Sigma (s_t,a_t)) p ( s 1 ) = N ( s t + 1 ; μ ( s t , a t ) , Σ ( s t , a t ))
然后使用解码器重构,把低维向量s t s_t s t o t o_t o t s t s_t s t
p ( o t ∣ s t ) p(\mathbf{o}_t | \mathbf{s}_t) p ( o t ∣ s t )
为了学习出这一模型,引入一个变分分布q ( s 1 : T ; o 1 : T ) q(\mathbf{s}_{1:T};\mathbf{o}_{1:T}) q ( s 1 : T ; o 1 : T ) q ( s 1 : T ∣ o 1 : T , a 1 : T ) q(\mathbf{s}_{1:T} | \mathbf{o}_{1:T},\mathbf{a}_{1:T}) q ( s 1 : T ∣ o 1 : T , a 1 : T ) 1 : T 1:T 1 : T
q ( s 1 : T ; o 1 : T ) = Π i q ( s t ; o t ) q(\mathbf{s}_{1:T};\mathbf{o}_{1:T})=\Pi_{i} q(\mathbf{s}_{t};\mathbf{o}_{t}) q ( s 1 : T ; o 1 : T ) = Π i q ( s t ; o t )
通俗来说,该编码器的意义是,引入一个编码器q ( s t ; o t ) q(s_t; o_t) q ( s t ; o t ) s t s_t s t o t o_t o t p ( s 1 : T ∣ o 1 : T , a 1 : T ) p(s_1:T\vert{}o_1:T, a_1:T) p ( s 1 : T ∣ o 1 : T , a 1 : T )
为了训练该模型,采用变分下界 ELBO:
ELBO = E q [ log p ( o t ∣ s t ) ] ⏟ 第一项:重构项 − D KL ( q s 1 ∥ p s 1 ) ⏟ 第二项:初始约束 − E q [ ∑ t = 1 T − 1 D KL ( q s t + 1 ( ⋅ ; o t + 1 ) ∥ p s t + 1 ( ⋅ ∣ s t , a t ) ) ] ⏟ 第三项:动态一致性约束 \text{ELBO} = \underbrace{\mathbb{E}_q [\log p(\mathbf{o}_t\vert{}\mathbf{s}_t)]}_{\text{第一项:重构项}} - \underbrace{D_{\text{KL}}(q_{\mathbf{s}_1} \parallel p_{\mathbf{s}_1})}_{\text{第二项:初始约束}} - \underbrace{\mathbb{E}_q \left[\sum_{t=1}^{T-1} D_{\text{KL}}(q_{\mathbf{s}_{t+1}}(\cdot;\mathbf{o}_{t+1}) \parallel p_{\mathbf{s}_{t+1}}(\cdot\vert{}\mathbf{s}_t, \mathbf{a}_t))\right]}_{\text{第三项:动态一致性约束}} ELBO = 第一项:重构项 E q [ log p ( o t ∣ s t )] − 第二项:初始约束 D KL ( q s 1 ∥ p s 1 ) − 第三项:动态一致性约束 E q [ t = 1 ∑ T − 1 D KL ( q s t + 1 ( ⋅ ; o t + 1 ) ∥ p s t + 1 ( ⋅ ∣ s t , a t )) ]
其中:
重构项 (Reconstruction Term):从s t s_t s t o t o_t o t s t s_t s t
初始约束 (Initial KL Divergence):第一个时刻预测的状态分布,不能偏离预设的先验分布p ( s 1 ) p(s_1) p ( s 1 )
动态一致性约束 (Transition KL Divergence):要求“用下一张图片直接编码出的状态q ( s t + 1 ∣ o t + 1 ) q(s_{t+1}\vert{}o_{t+1}) q ( s t + 1 ∣ o t + 1 ) p ( s t + 1 ∣ s t , a t ) p(s_{t+1}\vert{}s_t, a_t) p ( s t + 1 ∣ s t , a t )
该部分利用翻译好的机器人图像序列,提炼出纯粹的物理状态轨迹s 1 : T \mathbf{s}_{1:T} s 1 : T s T \mathbf{s}_T s T p ( s t + 1 ∣ s t , a t ) p(\mathbf{s}_{t+1} \vert{} \mathbf{s}_t, \mathbf{a}_t) p ( s t + 1 ∣ s t , a t ) a t \mathbf{a}_t a t
基于示范的自动化视觉指令执行技术 (AVID, Automated Visual Instruction-Following with Demonstrations)
该技术的目标是,在最少的人员投入、专业知识以及设备需求的情况下,实现机器人的学习功能。
CycleGAN 的训练
首先,需要训练 CycleGAN,其需要来自源域和目标域的训练数据。研究者发现,使用多样化的数据对于捕捉各种可能的场景以及生成真实的转换效果非常重要。
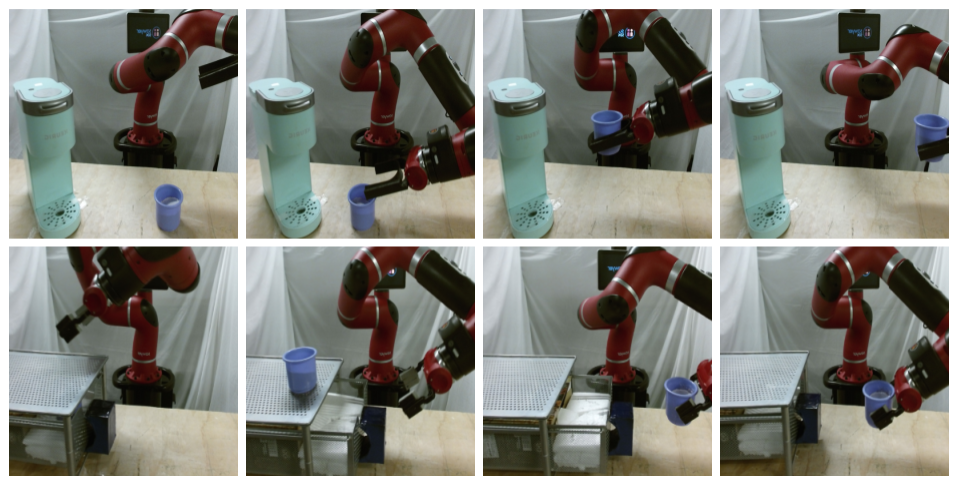
为此,研究者从人类域中提取的训练图像中包含了人类的行为表现,同时包含了少量“随机”数据——在这些数据中,人类只是在场景中自由移动,并没有刻意执行特定的任务。而从机器人域中提取的训练图像则完全由机器人执行随机采样的行为组成,如上图所示,在这些场景中,研究者会通过随机改变物体的位置或给机器人提供可握持的物品来手动调整环境。
这类人类干预行为并不需要任何特殊的设备或技术能力,研究者发现,只需少量此类干预措施就足以完成 CycleGAN 的数据收集任务。因此,与提供一系列机器人演示相比,这种整体操作方式所需的人工专业知识和努力要少得多。
基于关键帧或状态的模仿学习
训练好 CycleGAN 模型后,可通过从 CycleGAN 翻译好的机器人视频中选择一些关键帧或状态来进行模仿学习。对于多阶段任务来说,通过提取并学习那些与各个阶段完成相对应的关键帧,从而实现目标的分离的方式尤为自然,因为在多阶段任务 中,实现对整体成功至关重要的特定状态,比精确匹配特定的轨迹要重要得多。
在多阶段任务中,第i i i t i t_i t i { t 1 , ⋯ , t s } \{ t_1, \cdots, t_s \} { t 1 , ⋯ , t s } o t i \mathbf{o}_{t_i} o t i { C 1 , ⋯ , C s } \{ \mathcal{C_1},\cdots,\mathcal{C_{s}} \} { C 1 , ⋯ , C s } C i \mathcal{C}_i C i t i t_i t i
进一步为了做到高效控制,研究者通过隐空间 MPC 规划,首先使用q ( s t , o t ) q(\mathbf{s}_t,\mathbf{o}_{t}) q ( s t , o t ) s t \mathbf{s}_t s t ( a t , a t + 1 , … ) ( \mathbf{a}_{t}, \mathbf{a}_{t+1}, \dots ) ( a t , a t + 1 , … ) p ( s t + 1 ∣ s t , a t ) p(\mathbf{s}_{t+1}\vert{}\mathbf{s}_t, \mathbf{a}_t) p ( s t + 1 ∣ s t , a t ) s t + k s_{t+k} s t + k C i \mathcal{C}_i C i
潜在空间模型预测控制方法潜在空间模型预测控制方法 。该方法采用基于采样优化的交叉熵方法来迭代寻找最优的动作序列。在搜索过程中,会评估潜在空间中由模型生成的轨迹,这些轨迹的奖励函数由研究者设计的分类器给出。随后,机器人会执行优化出的动作序列中的第一个动作。s s s C s \mathcal{C}_{s} C s α ∈ [ 0 , 1 ] \alpha \in [0,1] α ∈ [ 0 , 1 ] C s − 1 \mathcal{C}_{s-1} C s − 1 K K K C s + 1 \mathcal{C}_{s+1} C s + 1 C s \mathcal{C}_{s} C s
实验结果
该项目的实验探索三个问题:
AVID 能否直接从人类演示中解决时间跨度较长的基于视觉的任务?
使用教学图像和潜在空间规划能给我们带来哪些好处(如果有的话)?
如果我们无法直接观看机器人演示,会产生哪些成本(如果有的话)?
方法对比
该研究使用以下方法和 AVID 作对比:
行为克隆 (Behavioral Cloning, BC) :利用专家遥控操作(Teleoperation)获取的“观察-动作”数据,直接进行监督学习来拟合策略。该方法作为拥有完整动作标注的“理想基线”。因其不具备阶段概念且存在单步误差累积(分布偏移)问题,以此证明 AVID “分阶段强化学习” 的优势。基于观察的行为克隆 (BCO) :同样使用遥控数据,但假设无法获取动作,仅有图像观察。先训练一个逆模型(Inverse Model)去“反推”动作,再利用推断出的动作做行为克隆。评估在缺乏直接动作标注时,仅靠“反推动作+克隆”的表现,作为无动作监督下的基础基线。全视频消融 (Full-video Ablation) :不将任务拆解为关键阶段,而是直接使用完整的真人演示视频(经域转换后),结合 BCO 算法进行端到端模仿学习。验证 AVID “仅抽取阶段指令图像” 的轻量化设计是否比“直接学习整段连续视频”更高效且有效。像素空间消融 (Pixel-space Ablation / DVF) :保留 AVID 的分阶段训练、学习重置和人工反馈机制,但将其中的“隐空间(Latent Space)规划”替换为基于 DVF(深度视觉预测)的“像素空间(Pixel Space)规划”。控制其他变量一致,专门验证 AVID 在 “高维隐空间中进行规划” 相比于“直接在原始像素空间规划”的性能提升。时间对比网络 (TCN) :通过时序一致性损失(Temporal Consistency)学习单视角人类视频的表征嵌入,并以当前轨迹与人类演示在特征空间中的距离(负欧氏距离)作为 RL 的奖励信号。验证 AVID 所采用的 “阶段分类器奖励” 是否优于这种基于“时序嵌入特征距离”的经典特征奖励机制。
实验结果
研究使用两个视觉领域的、时间跨度较长的任务来评估 AVID 方法:操作个人咖啡机和从关闭的抽屉中取出杯子。这些任务表明,AVID 方法能够通过遵循从人类演示中提取的一系列指令,学习按顺序组合多种技能。
监督 (Supervision) 方法 (Method) 咖啡制作 咖啡制作 咖啡制作 杯子取出 杯子取出 杯子取出 杯子取出 杯子取出 Human Demos AVID (ours) 100% 80% 80% 100% 100% 100% 80% 70% Human Demos Full-video ablation 70% 10% 0% 0% 0% 0% 0% 0% Human Demos Pixel-space ablation 60% 20% 0% 50% 50% 30% 10% 0% Human Demos TCN [46] 10% 10% 0% 60% 20% 0% 0% 0% Teleoperated Robot Demos BCO [56] 80% 30% 0% 30% 10% 0% 0% 0% Teleoperated Robot Demos Behavioral Cloning 90% 90% 90% 100% 100% 60% 60% 40%
Learning Generalizable Robotic Reward Functions from “In-The-Wild” Human Videos (领域无关视频判别器, DVD)
视频平台中具有大量真实场景数据,但利用这类“真实场景”的人类数据进行机器人学习会面临诸多挑战,包括:观察空间差异、智能体形态与场景视觉呈现差异、人类和机器人的动作空间差异、视频噪声大且质量参差不齐等等。
此前的相关研究已大量关注逆强化学习或逆最优控制问题,即从任务演示中学习奖励函数的问题;进一步的,本研究聚焦于学习用于视觉机器人操作的可泛化的多任务奖励函数,该函数可通过对“展示人类完成任务的单个视频”进行条件化,为不同的任务生成奖励。
另外,也有许多研究探讨了如何从人类视频中学习机器人行为,包括在人类视频中显式进行物体或手部跟踪、通过像素转换讲人类演示或目标转换为机器人视角、对人类视频中的动作/奖励/状态值进行推测等等。
此外,许多先前的研究也探讨了如何利用广泛的数据集来增强机器人学习的泛化能力。这些研究主要集中于如何以可扩展的方式收集大型且多样化的机器人数据集,以及如何以离线或在线的方式从这类数据中学习通用策略等。
针对上述问题和已有研究进展,本研究提出方法——领域无关视频判别器 (DVD),来预测两个视频是否在完成相同的任务。具体来说,通过利用许多人类视频数据集自带的活动标签,以及少量机器人演示视频,该模型能够捕捉来自截然不同视觉领域的视频之间的功能相似性。训练完成后,DVD 以一段人类视频作为演示,以机器人的行为作为另一段视频,并输出一个分数,该分数可以有效地衡量任务的成功或奖励。
问题陈述与奖励函数设计
记机器人完成K K K T = { T i } i = 1 K \mathcal{T} = \{\mathcal{T}_i\}_{i=1}^K T = { T i } i = 1 K T i \mathcal{T}_i T i R i \mathcal{R}_i R i T i \mathcal{T}_i T i M r i = ( S , A r , p r , R i , T ) \mathcal{M}_r^i = (\mathcal{S}, \mathcal{A}_r, p_r, \mathcal{R}_i, T) M r i = ( S , A r , p r , R i , T ) M h i = ( S , A h , p h , R i , T ) \mathcal{M}_h^i = (\mathcal{S}, \mathcal{A}_h, p_h, \mathcal{R}_i, T) M h i = ( S , A h , p h , R i , T )
在此设定下,双方共享以 RGB 图像表征的状态空间S \mathcal{S} S R i \mathcal{R}_i R i T T T A r \mathcal{A}_r A r A h \mathcal{A}_h A h p r ( s t + 1 ∣ s t , a t r ) p_r(s_{t+1} \mid s_t, a_t^r) p r ( s t + 1 ∣ s t , a t r ) p h ( s t + 1 ∣ s t , a t h ) p_h(s_{t+1} \mid s_t, a_t^h) p h ( s t + 1 ∣ s t , a t h )
任务奖励函数R i \mathcal{R}_{i} R i
假设任务奖励函数R i \mathcal{R}_{i} R i t t t H ≤ T H \leq T H ≤ T
Given T = { T i } i = 1 K , d i = s 1 : t d i ∗ ∈ S t d i where M r i = ( S , A r , p r , R i , T ) , M h i = ( S , A h , p h , R i , T ) s.t. S ⊆ R H × W × 3 p r : S × A r → Δ ( S ) , p h : S × A h → Δ ( S ) A r ≠ A h , p r ≠ p h R i : S H → R Find R θ : S H × S ∗ → R s.t. R θ ( s 1 : H , d i ) ≈ R i ( s 1 : H ) , ∀ i ∈ { 1 , … , K } , s 1 : H ∈ S H \begin{aligned}
& \text{Given } \mathcal{T} = \{\mathcal{T}_i\}_{i=1}^K, \quad d_i = s_{1:t_{d_i}}^* \in \mathcal{S}^{t_{d_i}} \\
& \text{where } \mathcal{M}_r^i = (\mathcal{S}, \mathcal{A}_r, p_r, \mathcal{R}_i, T), \quad \mathcal{M}_h^i = (\mathcal{S}, \mathcal{A}_h, p_h, \mathcal{R}_i, T) \\
& \text{s.t.} \\
& \quad \mathcal{S} \subseteq \mathbb{R}^{H \times W \times 3} \\
& \quad p_r: \mathcal{S} \times \mathcal{A}_r \to \Delta(\mathcal{S}), \quad p_h: \mathcal{S} \times \mathcal{A}_h \to \Delta(\mathcal{S}) \\
& \quad \mathcal{A}_r \neq \mathcal{A}_h, \quad p_r \neq p_h \\
& \quad \mathcal{R}_i: \mathcal{S}^H \to \mathbb{R} \\
& \text{Find } \mathcal{R}_\theta: \mathcal{S}^H \times \mathcal{S}^* \to \mathbb{R} \\
& \text{s.t. } \mathcal{R}_\theta(s_{1:H}, d_i) \approx \mathcal{R}_i(s_{1:H}), \quad \forall i \in \{1, \dots, K\}, \, s_{1:H} \in \mathcal{S}^H
\end{aligned} Given T = { T i } i = 1 K , d i = s 1 : t d i ∗ ∈ S t d i where M r i = ( S , A r , p r , R i , T ) , M h i = ( S , A h , p h , R i , T ) s.t. S ⊆ R H × W × 3 p r : S × A r → Δ ( S ) , p h : S × A h → Δ ( S ) A r = A h , p r = p h R i : S H → R Find R θ : S H × S ∗ → R s.t. R θ ( s 1 : H , d i ) ≈ R i ( s 1 : H ) , ∀ i ∈ { 1 , … , K } , s 1 : H ∈ S H 其中,T i \mathcal{T}_i T i K K K d i d_i d i M r i \mathcal{M}_r^i M r i M h i \mathcal{M}_h^i M h i S \mathcal{S} S H × W H\times W H × W T T T R i \mathcal{R}_i R i A r , A h \mathcal{A}_r, \mathcal{A}_h A r , A h p r , p h p_r, p_h p r , p h H H H s 1 : H s_{1:H} s 1 : H R θ \mathcal{R}_\theta R θ s 1 : H s_{1:H} s 1 : H d i d_i d i R i \mathcal{R}_i R i
奖励函数R θ ( s 1 : H , d i ) \mathcal{R}_\theta(s_{1:H}, d_i) R θ ( s 1 : H , d i )
为训练奖励函数R θ \mathcal{R}_\theta R θ
Given Datasets D h = { D T i h } i = 1 N , D r = { D T i r } i = 1 M s.t. M ≤ N < K , M ≪ N { T i } i = 1 M ⊂ { T i } i = 1 N ⊂ { T i } i = 1 K D T i h = { d i , j h } j = 1 n i h , D T i r = { d i , k r } k = 1 n i r , n i r ≪ n i h d i , j h , d i , k r ∈ S ∗ = ⋃ t = 1 ∞ S t , S ⊆ R H × W × 3 a t h , a t r ∉ Observed , s low-dim ∉ Observed P ( S ∣ D h ) ≠ P ( S ∣ D r ) \begin{aligned}
& \text{Given Datasets } \mathcal{D}_h = \{\mathcal{D}_{\mathcal{T}_i}^h\}_{i=1}^N, \quad \mathcal{D}_r = \{\mathcal{D}_{\mathcal{T}_i}^r\}_{i=1}^M \\
& \text{s.t.} \\
& \quad M \le N < K, \quad M \ll N \\
& \quad \{\mathcal{T}_i\}_{i=1}^M \subset \{\mathcal{T}_i\}_{i=1}^N \subset \{\mathcal{T}_i\}_{i=1}^K \\
& \quad \mathcal{D}_{\mathcal{T}_i}^h = \{ d_{i,j}^h \}_{j=1}^{n_i^h}, \quad \mathcal{D}_{\mathcal{T}_i}^r = \{ d_{i,k}^r \}_{k=1}^{n_i^r}, \quad n_i^r \ll n_i^h \\
& \quad d_{i,j}^h, d_{i,k}^r \in \mathcal{S}^* = \bigcup_{t=1}^{\infty} \mathcal{S}^t, \quad \mathcal{S} \subseteq \mathbb{R}^{H \times W \times 3} \\
& \quad a_t^h, a_t^r \notin \text{Observed}, \quad s_{\text{low-dim}} \notin \text{Observed} \\
& \quad \mathbb{P}(\mathcal{S} \mid \mathcal{D}_h) \neq \mathbb{P}(\mathcal{S} \mid \mathcal{D}_r)
\end{aligned} Given Datasets D h = { D T i h } i = 1 N , D r = { D T i r } i = 1 M s.t. M ≤ N < K , M ≪ N { T i } i = 1 M ⊂ { T i } i = 1 N ⊂ { T i } i = 1 K D T i h = { d i , j h } j = 1 n i h , D T i r = { d i , k r } k = 1 n i r , n i r ≪ n i h d i , j h , d i , k r ∈ S ∗ = t = 1 ⋃ ∞ S t , S ⊆ R H × W × 3 a t h , a t r ∈ / Observed , s low-dim ∈ / Observed P ( S ∣ D h ) = P ( S ∣ D r ) 数据集中,D h \mathcal{D}_h D h D r \mathcal{D}_r D r N N N M M M M ≪ N < K M \ll N < K M ≪ N < K d i , j h d_{i,j}^h d i , j h d i , k r d_{i,k}^r d i , k r n i h n_i^h n i h n i r n_i^r n i r a t a_t a t P ( S ∣ D h ) ≠ P ( S ∣ D r ) \mathbb{P}(\mathcal{S} \mid \mathcal{D}_h) \neq \mathbb{P}(\mathcal{S} \mid \mathcal{D}_r) P ( S ∣ D h ) = P ( S ∣ D r )
评估阶段旨在以目标演示为条件隐式推断奖励信号,既要保障已知任务的高效解决,又要实现对未见过新任务的零样本(Zero-Shot)泛化。
Goal: Optimize π ∗ = arg max π E τ ∼ π [ ∑ t = 1 T R θ ( s 1 : t , d ) ] s.t. Task Completion: d = d i ⟹ Solves T i , ∀ T i ∈ { T k } k = 1 N Zero-Shot Generalization: d = d new ⟹ Solves T new , ∀ T new ∉ { T k } k = 1 N \begin{aligned}
& \text{Goal: Optimize } \pi^* = \arg\max_\pi \mathbb{E}_{\tau \sim \pi} \left[ \sum_{t=1}^T \mathcal{R}_\theta(s_{1:t}, d) \right] \\
& \text{s.t.} \\
& \quad \text{Task Completion: } d = d_i \implies \text{Solves } \mathcal{T}_i, \quad \forall \mathcal{T}_i \in \{\mathcal{T}_k\}_{k=1}^N \\
& \text{Zero-Shot Generalization: } d = d_{\text{new}} \implies \text{Solves } \mathcal{T}_{\text{new}}, \quad \forall \mathcal{T}_{\text{new}} \notin \{\mathcal{T}_k\}_{k=1}^N
\end{aligned} Goal: Optimize π ∗ = arg π max E τ ∼ π [ t = 1 ∑ T R θ ( s 1 : t , d ) ] s.t. Task Completion: d = d i ⟹ Solves T i , ∀ T i ∈ { T k } k = 1 N Zero-Shot Generalization: d = d new ⟹ Solves T new , ∀ T new ∈ / { T k } k = 1 N 公式表达了策略π ∗ \pi^* π ∗ R θ \mathcal{R}_\theta R θ R θ \mathcal{R}_\theta R θ 条件化表征 与跨任务泛化 能力——当输入已知任务的演示d i d_i d i T i \mathcal{T}_i T i d new d_{\text{new}} d new T new \mathcal{T}_{\text{new}} T new
Domain-Agnostic Video Discriminators (DVD,领域无关视频判别器)
判别器训练与损失函数设计
DVD 的核心思想是将奖励函数建模为任务功能相似度分类器,通过判断两段跨域视频(人类或机器人)是否完成同一任务,从而学习对领域变化鲁棒的隐式奖励信号。
Sample d i , d i ′ ∈ D T i h ∪ D T i r , d j ∈ D T j h ∪ D T j r s.t. i ≠ j Minimize J ( θ ) = − E ( d i , d i ′ , d j ) ∼ D h ∪ D r [ log R θ ( d i , d i ′ ) + log ( 1 − R θ ( d i , d j ) ) ] s.t. R θ : S ∗ × S ∗ → [ 0 , 1 ] R θ ( d i , d i ′ ) → 1 ( Same Task T i ) R θ ( d i , d j ) → 0 ( Different Tasks T i ≠ T j ) \begin{aligned}
& \text{Sample } d_i, d_i' \in \mathcal{D}_{\mathcal{T}_i}^h \cup \mathcal{D}_{\mathcal{T}_i}^r, \quad d_j \in \mathcal{D}_{\mathcal{T}_j}^h \cup \mathcal{D}_{\mathcal{T}_j}^r \quad \text{s.t. } i \neq j \\
& \text{Minimize } \mathcal{J}(\theta) = -\mathbb{E}_{(d_i, d_i', d_j) \sim \mathcal{D}_h \cup \mathcal{D}_r} \left[ \log \mathcal{R}_\theta(d_i, d_i') + \log (1 - \mathcal{R}_\theta(d_i, d_j)) \right] \\
& \text{s.t.} \\
& \quad \mathcal{R}_\theta: \mathcal{S}^* \times \mathcal{S}^* \to [0, 1] \\
& \quad \mathcal{R}_\theta(d_i, d_i') \to 1 \quad (\text{Same Task } \mathcal{T}_i) \\
& \quad \mathcal{R}_\theta(d_i, d_j) \to 0 \quad (\text{Different Tasks } \mathcal{T}_i \neq \mathcal{T}_j)
\end{aligned} Sample d i , d i ′ ∈ D T i h ∪ D T i r , d j ∈ D T j h ∪ D T j r s.t. i = j Minimize J ( θ ) = − E ( d i , d i ′ , d j ) ∼ D h ∪ D r [ log R θ ( d i , d i ′ ) + log ( 1 − R θ ( d i , d j )) ] s.t. R θ : S ∗ × S ∗ → [ 0 , 1 ] R θ ( d i , d i ′ ) → 1 ( Same Task T i ) R θ ( d i , d j ) → 0 ( Different Tasks T i = T j ) 损失函数J ( θ ) \mathcal{J}(\theta) J ( θ ) D h ∪ D r \mathcal{D}_h \cup \mathcal{D}_r D h ∪ D r ( d i , d i ′ ) (d_i, d_i') ( d i , d i ′ ) T i \mathcal{T}_i T i ( d i , d j ) (d_i, d_j) ( d i , d j ) T i ≠ T j \mathcal{T}_i \neq \mathcal{T}_j T i = T j R θ \mathcal{R}_\theta R θ
DVD 网络架构与跨域采样策略
在实现层面,DVD 将固定预训练的 3D 卷积视频编码器与待优化的相似度计算网络进行解耦,并通过跨域平衡采样机制缓解非对称数据分布导致的领域偏差。
Architecture: R θ ( d i , d j ) = f sim ( f enc ( d i ) , f enc ( d j ) ; θ ) s.t. h i = f enc ( d i ) ∈ R d , f enc frozen (Pretrained on Sth-Sth V2) f sim : R d × R d → [ 0 , 1 ] , θ trainable (MLP) P ( d ∈ D r ) = 0.5 , P ( d ∈ D h ) = 0.5 ∀ d ∈ { d i , d i ′ , d j } \begin{aligned}
& \text{Architecture: } \mathcal{R}_\theta(d_i, d_j) = f_{\text{sim}}(f_{\text{enc}}(d_i), f_{\text{enc}}(d_j); \theta) \\
& \text{s.t.} \\
& \quad h_i = f_{\text{enc}}(d_i) \in \mathbb{R}^d, \quad f_{\text{enc}} \text{ frozen (Pretrained on Sth-Sth V2)} \\
& \quad f_{\text{sim}}: \mathbb{R}^d \times \mathbb{R}^d \to [0, 1], \quad \theta \text{ trainable (MLP)} \\
& \quad \mathbb{P}(d \in \mathcal{D}_r) = 0.5, \quad \mathbb{P}(d \in \mathcal{D}_h) = 0.5 \quad \forall d \in \{d_i, d_i', d_j\}
\end{aligned} Architecture: R θ ( d i , d j ) = f sim ( f enc ( d i ) , f enc ( d j ) ; θ ) s.t. h i = f enc ( d i ) ∈ R d , f enc frozen (Pretrained on Sth-Sth V2) f sim : R d × R d → [ 0 , 1 ] , θ trainable (MLP) P ( d ∈ D r ) = 0.5 , P ( d ∈ D h ) = 0.5 ∀ d ∈ { d i , d i ′ , d j } 式中f enc f_{\text{enc}} f enc h h h f sim f_{\text{sim}} f sim θ \theta θ 50 % 50\% 50%
基于 DVD 的视觉模型预测控制 (VMPC)
在控制决策阶段,由于 DVD 仅提供标量评估信号而缺乏梯度控制动作的能力,研究采用视觉模型预测控制(VMPC)结合交叉熵方法(CEM)在隐式的视觉动力学推演中选择最优动作序列。
Given Current Observation s t and Goal Demo d i Model: s ~ t + 1 : t + H ∼ p ϕ ( s t + 1 : t + H ∣ s t , a t : t + H ) ( SV2P Dynamics ) Action Optimization: a t : t + H ∗ = arg max a t : t + H R θ ( s ~ t + 1 : t + H , d i ) s.t. { a t : t + H ( g ) } g = 1 G ∼ CEM ( μ , Σ ) s ~ t + 1 : t + H ( g ) ∼ p ϕ ( s t , a t : t + H ( g ) ) , g ∈ { 1 , … , G } Execute a t ∗ from a t : t + H ∗ = arg max { a ( g ) } R θ ( s ~ t + 1 : t + H ( g ) , d i ) \begin{aligned}
& \text{Given Current Observation } s_t \text{ and Goal Demo } d_i \\
& \text{Model: } \tilde{s}_{t+1:t+H} \sim p_\phi(s_{t+1:t+H} \mid s_t, a_{t:t+H}) \quad (\text{SV2P Dynamics}) \\
& \text{Action Optimization: } a_{t:t+H}^* = \arg\max_{a_{t:t+H}} \mathcal{R}_\theta(\tilde{s}_{t+1:t+H}, d_i) \\
& \text{s.t.} \\
& \quad \{a_{t:t+H}^{(g)}\}_{g=1}^G \sim \text{CEM}(\mu, \Sigma) \\
& \quad \tilde{s}_{t+1:t+H}^{(g)} \sim p_\phi(s_t, a_{t:t+H}^{(g)}), \quad g \in \{1, \dots, G\} \\
& \quad \text{Execute } a_t^* \text{ from } a_{t:t+H}^* = \arg\max_{\{a^{(g)}\}} \mathcal{R}_\theta(\tilde{s}_{t+1:t+H}^{(g)}, d_i)
\end{aligned} Given Current Observation s t and Goal Demo d i Model: s ~ t + 1 : t + H ∼ p ϕ ( s t + 1 : t + H ∣ s t , a t : t + H ) ( SV2P Dynamics ) Action Optimization: a t : t + H ∗ = arg a t : t + H max R θ ( s ~ t + 1 : t + H , d i ) s.t. { a t : t + H ( g ) } g = 1 G ∼ CEM ( μ , Σ ) s ~ t + 1 : t + H ( g ) ∼ p ϕ ( s t , a t : t + H ( g ) ) , g ∈ { 1 , … , G } Execute a t ∗ from a t : t + H ∗ = arg { a ( g ) } max R θ ( s ~ t + 1 : t + H ( g ) , d i ) 控制流程首先依靠基于 SV2P 训练的动作条件视觉动力学模型p ϕ p_\phi p ϕ s t s_t s t G G G s ~ t + 1 : t + H ( g ) \tilde{s}_{t+1:t+H}^{(g)} s ~ t + 1 : t + H ( g ) d i d_i d i R θ \mathcal{R}_\theta R θ
综上所述,该框架构建了一个“跨域离线表征学习 + 在线视觉模型预测规划”的端到端具身智能决策闭环。整个系统在完全摒弃低维状态和动作标签的严苛设定下,巧妙地解决了跨具身(人类到机器人)的任务迁移难题。其核心设计哲学在于将“识别任务是否完成”(由 DVD 负责)与“预测物理世界演变”(由 SV2P 负责)进行解耦与协同控制。
在训练阶段,系统并行推进两套完全解耦的学习通道:
任务奖励学习(DVD) :联合庞大的无标注人类演示语料D h \mathcal{D}_h D h D r \mathcal{D}_r D r 50 % 50\% 50% R θ \mathcal{R}_\theta R θ 物理动力学学习(SV2P) :利用机器人无监督探索数据,以自监督方式独立训练动作条件的视频预测模型p ϕ p_\phi p ϕ
在部署阶段,面对已知任务或未见过的新任务演示d i d_i d i
脑海演练(Imagination):机器人结合当前时刻的真实视觉观察s t s_t s t s ~ t + 1 : t + H \tilde{s}_{t+1:t+H} s ~ t + 1 : t + H
相似度评估(Evaluation):冻结的 DVD 奖励函数充当“裁判”,将每一条虚拟演练的画面序列与目标人类演示d i d_i d i
滚动时域控制(Receding Horizon Execution):选择打分最高的那条演练轨迹,并将该轨迹的首步动作a t ∗ a_t^* a t ∗
这一机制成功打通了从“高层跨域人类演示视频”到“底层机器人连续物理动作”的映射,既保障了离线训练的高效性,又具备了在线规划对新任务的零样本泛化能力。
Algorithm 1 Domain-agnostic Video Discriminator (DVD)
算法 1 领域无关视频判别器 (DVD)

 1: // Training DVD
    // 培训 DVD
 2: Require: 𝒟h human demonstration data for N tasks {𝒯n}
    要求: 𝒟h 项任务的人工演示数据 N {𝒯n}
 3: Require: 𝒟r robot demonstration data for M tasks {𝒯m} ⊆ {𝒯n}
    要求: 𝒟r 个机器人演示数据,用于 M 个任务 {𝒯m} ⊆ {𝒯n}
 4: Require: Pre-trained video encoder f_enc
    要求: 预训练视频编码器 f_enc
 5: Randomly initialize θ
    随机初始化 θ
 6: while training do
    训练期间
 7:     Sample anchor video di ∈ 𝒟h ∪ 𝒟r
        示例锚视频 di ∈ 𝒟h ∪ 𝒟r
 8:     Sample positive video di' ∈ {𝒟_{𝒯i}^h} ∪ {𝒟_{𝒯i}^r} \ di
        正面视频示例 di' ∈ {𝒟_{𝒯i}^h} ∪ {𝒟_{𝒯i}^r} \ di
 9:     Sample negative video dj ∈ {𝒟_{𝒯j}^h} ∪ {𝒟_{𝒯j}^r} ∀j ≠ i
        负片样本 dj ∈ {𝒟_{𝒯j}^h} ∪ {𝒟_{𝒯j}^r} ∀j ≠ i
10:     Update ℛθ with di, di', dj according to Eq. 1
        根据公式 1 将 ℛθ 更新为 di, di', dj
11: // Planning Conditioned on Video Demo
    // 根据视频演示进行规划
12: Require: Trained reward function ℛθ & video prediction model pϕ
    要求: 已训练的奖励函数 ℛθ 和视频预测模型 pϕ
13: Require: Human video demo di for task 𝒯i
    要求: 任务 𝒯i 的人类视频演示 di
14: for trials 1,…,n do
    对于试验 1,…,n 执行
15:     Sample {a_{1:H}^{1:G}} & get predictions {s~_{1:H}^g} ∼ {pϕ(s0, a_{1:H}^g)}
        采样 {a_{1:H}^{1:G}} 并获得预测结果 {s~_{1:H}^g} ∼ {pϕ(s0, a_{1:H}^g)}
16:     Step a*_{1:H} which maximizes ℛθ(s~_{1:H}^g, di)
        步骤 a*_{1:H} 最大化 ℛθ(s~_{1:H}^g, di)
实验结果
核心研究问题
本实验旨在评估 DVD 能否通过跨域人类视频提升机器人对新环境与新任务的泛化能力,重点回答四个问题:
环境泛化 :利用人类视频能否帮助模型泛化至未见过的物理环境?任务泛化 :人类视频的多样性能否支持模型零样本迁移至全新任务?单样本模仿 :相比已有基线,DVD 能否更有效地从“单次”人类演示中推断奖励?真机落地 :DVD 学到的奖励函数能否直接驱动真实机器人完成控制规划?
实验设置
仿真实验基于改编自 Meta-World 的 MuJoCo 桌面环境,包含 Sawyer 机械臂与抽屉、水龙头、咖啡机等物体的交互。为了系统评估环境泛化能力,实验设计了四个难度递增的环境变体(Train Env 以及引入颜色改变的Test Env 1、增加视角变化的Test Env 2、叠加物体重新排列的Test Env 3)。评估的三项核心目标任务包括:关抽屉、右转水龙头、推开咖啡杯,且均由未公开的真实人类视频作为任务指定。
数据集方面,人类演示选用 Something-Something-V2 数据集(22 万余条视频,包含 174 类日常人类动作),根据配置抽取 3 至 15 种任务的数据;机器人演示则仅在初始训练环境下收集 3 个任务的 120 条轨迹(后续消融实验验证了更少数据下的表现)。
仿真实验:环境与任务泛化
在环境泛化实验 中,将仅用机器人数据训练的模型(Robot Only)与引入不同数量人类任务数据(Robot + K Human Tasks)的模型进行对比。结果表明,引入人类视频可将跨环境任务成功率平均提升 20% 。即使仅引入与目标任务完全无关的人类视频(如K > 3 K > 3 K > 3
在任务泛化实验 中,训练阶段完全屏蔽了三个目标任务的任何机器或人类数据,仅依靠无关任务进行学习。实验发现,Robot Only 在面对未见过的人类演示时,往往只会盲目移动到环境的固定区域,无法识别新任务;而加入 6 个以上无关人类任务后,模型的任务泛化成功率提升超过20% (如 9 个人类任务配置下平均成功率达 55.11%)。这说明多样化的人类动作视角对于模型提取通用的“任务功能语义”至关重要。
基线对比与真机验证
与已有代表性工作的对比进一步体现了 DVD 的架构优势:
对比 Concept2Robot (纯人类数据预训练视频分类器):DVD 平均成功率高出 20%,证明极少量机器人数据 对跨越“人-机具身鸿沟”不可或缺。对比演示条件行为克隆(BC) :DVD 性能领先 30% 以上。BC 方法在多样化人类视频输入下容易陷入单一轨迹模仿,而 DVD 成功将“奖励评估”与“轨迹规划(Visual MPC)”解耦,极大地降低了数据依赖。
在WidowX200 真实机器人 评估中(训练于文件柜环境,测试于玩具厨房环境),结合人类视频训练的 DVD 模型在未知环境下的成功率达到65%–70% ,为纯机器人数据模型(最高 40%)的2 倍左右 。最后的数据量消融实验表明,即便将每个任务的机器人演示从 120 条大幅削减至20 条 ,DVD 的泛化性能也仅有轻微下降,证明了其在具身数据稀缺场景下的极高实用价值。
VIP: Towards Universal Visual Reward and Representation via Value-Implicit Pre-Training (通过价值隐性预训练实现通用视觉奖励和表征)
机器人控制预训练的一个关键未解难题是奖励设定的挑战。与模拟环境不同,现实世界的机器人任务并不具备预先设定的环境状态信息,也没有定义在该状态空间上的良好奖励函数。以往用于控制的预训练表征仅在模拟环境下的视觉强化学习(RL)中取得了一定的成果,前提是能够获取良好稠密的奖励函数或者通过视觉模仿学习(IL),无论采用哪种方法,学习每个新任务都需要大量的工程投入。
相比之下,一种简单通用的现实世界操作任务设定方法是提供一个目标图像,该目标图像能够捕捉环境所需的视觉变化。然而,正如我们在实验中所展示的,尽管现有的预训练视觉表征作为纯粹的视觉编码器非常有效,但它们并不能产生有效的奖励函数,例如与目标图像的嵌入距离。这就引出了一个关键问题:是否有可能完全从域外数据中学习到通用的视觉奖励函数?
鉴于领域内特定任务的机器人数据固有的成本和稀缺性,从大型、多样化的离线人类视频中学习已成为获取通用控制视觉表征的一种途径;然而,如何将这些人类视频用于通用奖励学习仍然悬而未决。本研究提出了 价值隐式预训练 (VIP, Value-Implicit Pre-training),为未见过的机器人任务生成密集且平滑的奖励函数。本文证明,这种通用的奖励模型确实可以从预训练的视觉表征中导出。可以通过将从各种人类视频数据中学习表征视为一个大型离线目标条件强化学习问题来获取这种表征。
本研究的关键洞见在于,与其解决从域外、无动作视频中直接学习策略这个不可能的原始问题,不如解决目标条件价值函数学习的 Fenchel 对偶问题。这个对偶价值函数可以在完全自监督的情况下进行训练,无需动作信息,因此适用于在没有机器人动作标签的(域外)视频上进行预训练。
域外预训练的问题设置
本节定义了利用域外数据预训练视觉编码器,并在冻结编码器的马尔可夫决策过程(MDP)中进行策略评估的数学框架。
Given D = { v i = ( o 1 i , … , o h i i ) } i = 1 N s.t. o ∈ O ⊆ R H × W × 3 D ∼ P out-of-domain Find ϕ = A ( D ) : O → R K Given Task MDP M ( ϕ ) : = ( ϕ ( O ) , A , R ( o t , o t + 1 , ϕ , g ) , T , γ , g ) s.t. ϕ is frozen g ∈ O R ( o t , o t + 1 , ϕ , g ) = S ϕ ( o t + 1 , g ) − S ϕ ( o t , g ) S ϕ ( o , g ) = − ∥ ϕ ( o ) − ϕ ( g ) ∥ 2 Optimize π : R K → A s.t. a t ∼ π ( ϕ ( o t ) ) \begin{aligned}
& \text{Given } \mathcal{D} = \{v_i = (o_1^i, \dots, o_{h_i}^i)\}_{i=1}^N \\
& \text{s.t.} \\
& \quad o \in \mathcal{O} \subseteq \mathbb{R}^{H \times W \times 3} \\
& \quad \mathcal{D} \sim P_{\text{out-of-domain}} \\
& \text{Find } \phi = \mathcal{A}(\mathcal{D}): \mathcal{O} \to \mathbb{R}^K \\
& \text{Given Task MDP } \mathcal{M}(\phi) := \left( \phi(\mathcal{O}), \mathcal{A}, \mathcal{R}(o_t, o_{t+1}, \phi, g), \mathcal{T}, \gamma, g \right) \\
& \text{s.t.} \\
& \quad \phi \text{ is frozen} \\
& \quad g \in \mathcal{O} \\
& \quad \mathcal{R}(o_t, o_{t+1}, \phi, g) = \mathcal{S}_\phi(o_{t+1}, g) - \mathcal{S}_\phi(o_t, g) \\
& \quad \mathcal{S}_\phi(o, g) = - \|\phi(o) - \phi(g)\|_2 \\
& \text{Optimize } \pi: \mathbb{R}^K \to \mathcal{A} \quad \text{s.t. } a_t \sim \pi(\phi(o_t))
\end{aligned} Given D = { v i = ( o 1 i , … , o h i i ) } i = 1 N s.t. o ∈ O ⊆ R H × W × 3 D ∼ P out-of-domain Find ϕ = A ( D ) : O → R K Given Task MDP M ( ϕ ) := ( ϕ ( O ) , A , R ( o t , o t + 1 , ϕ , g ) , T , γ , g ) s.t. ϕ is frozen g ∈ O R ( o t , o t + 1 , ϕ , g ) = S ϕ ( o t + 1 , g ) − S ϕ ( o t , g ) S ϕ ( o , g ) = − ∥ ϕ ( o ) − ϕ ( g ) ∥ 2 Optimize π : R K → A s.t. a t ∼ π ( ϕ ( o t ))
数据集与输入相关 :
D \mathcal{D} D N N N v i v_i v i h i = 1 h_i=1 h i = 1 o ∈ O o \in \mathcal{O} o ∈ O 原始 RGB 图像 (分辨率为高H × H \times H × W × 3 W \times 3 W × 3 P out-of-domain P_{\text{out-of-domain}} P out-of-domain 域外数据分布 ,指预训练数据不包含任何机器人要做的具体任务或环境信息。
编码器与表征相关 :
A \mathcal{A} A 预训练算法 (比如各种自监督对比学习算法)。ϕ \phi ϕ 视觉特征提取器(编码器) ,把高维图片压缩成K K K ϕ ( O ) ∈ R K \phi(\mathcal{O}) \in \mathbb{R}^K ϕ ( O ) ∈ R K 低维状态空间 。测试时ϕ \phi ϕ 参数冻结 (Frozen)。
MDP 环境与任务相关 :
M ( ϕ ) \mathcal{M}(\phi) M ( ϕ ) ϕ \phi ϕ 下游评估马尔可夫决策过程 。g ∈ O g \in \mathcal{O} g ∈ O 目标图像 (Goal Image),代表希望机器最终把物体弄成的样子。A \mathcal{A} A T \mathcal{T} T γ \gamma γ 动作空间 、环境转移动力学 (物理规律)、折扣因子 。
奖励与策略相关 :
S ϕ ( o , g ) \mathcal{S}_\phi(o, g) S ϕ ( o , g ) o o o g g g 距离得分 (这里取负欧氏距离,特征越靠近,得分越接近 0)。R ( o t , o t + 1 , ϕ , g ) \mathcal{R}(o_t, o_{t+1}, \phi, g) R ( o t , o t + 1 , ϕ , g ) 整形后的标量奖励 ,等于“下一时刻相比上一时刻离目标的距离缩小了多少”。比旧状态更靠近目标就给正奖励,反之给负奖励。π \pi π 控制策略 ,输入当前图像提取出的特征向量ϕ ( o t ) \phi(o_t) ϕ ( o t ) a t a_t a t
Value-Implicit Pre-Training (VIP,价值型预训练)
本节提出价值隐式预训练 (VIP) 框架。首先从被动人类视频中推导离线 RL 的对偶价值函数目标,随后证明该目标等价于一种隐式时间对比学习,该特性诱导了时间上平滑的嵌入空间。最后利用负 L2 距离近似价值函数,构建无需显式学习 V 网络的极简算法。
基于人类视频的自监督价值学习
在人类视频中,虽然缺少机器人的动作标签A r \mathcal{A}_r A r a ~ H ∼ π H ( ϕ ( o ) ∣ ϕ ( g ) ) \tilde{a}_H \sim \pi_H(\phi(o) \mid \phi(g)) a ~ H ∼ π H ( ϕ ( o ) ∣ ϕ ( g ))
原问题为基于 KL 正则化的目标条件离线 RL 问题:
Maximize J ( π H , ϕ ) = E π H [ ∑ t = 0 ∞ γ t r ( o t , g ) ] − D KL ( d π H ( o , a ~ H ; g ) ∥ d D ( o , a ~ H ; g ) ) s.t. o , g ∈ O ⊆ R H × W × 3 a ~ H ∈ A H ( 隐式未观测动作 ) d D 为数据集 D H 的经验边际分布 \begin{aligned} & \text{Maximize } \mathcal{J}(\pi_H, \phi) = \mathbb{E}_{\pi_H} \left[ \sum_{t=0}^{\infty} \gamma^t r(o_t, g) \right] - D_{\text{KL}}\left( d^{\pi_H}(o, \tilde{a}_H; g) \parallel d^{\mathcal{D}}(o, \tilde{a}_H; g) \right) \\ & \text{s.t.} \\ & \quad o, g \in \mathcal{O} \subseteq \mathbb{R}^{H \times W \times 3} \\ & \quad \tilde{a}_H \in \mathcal{A}_H \quad (\text{隐式未观测动作}) \\ & \quad d^{\mathcal{D}} \text{ 为数据集 } \mathcal{D}_H \text{ 的经验边际分布} \end{aligned} Maximize J ( π H , ϕ ) = E π H [ t = 0 ∑ ∞ γ t r ( o t , g ) ] − D KL ( d π H ( o , a ~ H ; g ) ∥ d D ( o , a ~ H ; g ) ) s.t. o , g ∈ O ⊆ R H × W × 3 a ~ H ∈ A H ( 隐式未观测动作 ) d D 为数据集 D H 的经验边际分布
通过 Fenchel 对偶性(Fenchel Duality),消去不可观测的动作a ~ H \tilde{a}_H a ~ H
Optimization Problem (Dual Value Objective): min ϕ max V E g ∼ p ( g ) [ ( 1 − γ ) E o ∼ μ 0 ( o , g ) [ V ( ϕ ( o ) , ϕ ( g ) ) ] + log E ( o , o ′ , g ) ∼ D H [ exp ( r ( o , g ) + γ V ( ϕ ( o ′ ) , ϕ ( g ) ) − V ( ϕ ( o ) , ϕ ( g ) ) ) ] ] s.t. r ( o , g ) = δ g ~ ( o ) : = I ( o = = g ) − 1 ∈ { − 1 , 0 } ( o , o ′ ) ∼ D H ( 视频序列中的相邻时间步帧 ) \begin{aligned} & \text{Optimization Problem (Dual Value Objective):} \\ & \min_{\phi} \max_{V} \mathbb{E}_{g \sim p(g)} \left[ (1-\gamma) \mathbb{E}_{o \sim \mu_0(o,g)} [V(\phi(o), \phi(g))] \right. \\ & \qquad \qquad \qquad \left. + \log \mathbb{E}_{(o, o', g) \sim \mathcal{D}_H} \left[ \exp \left( r(o,g) + \gamma V(\phi(o'), \phi(g)) - V(\phi(o), \phi(g)) \right) \right] \right] \\ & \text{s.t.} \\ & \quad r(o,g) = \delta_{\tilde{g}}(o) := \mathbb{I}(o == g) - 1 \in \{-1, 0\} \\ & \quad (o, o') \sim \mathcal{D}_H \quad (\text{视频序列中的相邻时间步帧}) \end{aligned} Optimization Problem (Dual Value Objective): ϕ min V max E g ∼ p ( g ) [ ( 1 − γ ) E o ∼ μ 0 ( o , g ) [ V ( ϕ ( o ) , ϕ ( g ))] + log E ( o , o ′ , g ) ∼ D H [ exp ( r ( o , g ) + γ V ( ϕ ( o ′ ) , ϕ ( g )) − V ( ϕ ( o ) , ϕ ( g )) ) ] ] s.t. r ( o , g ) = δ g ~ ( o ) := I ( o == g ) − 1 ∈ { − 1 , 0 } ( o , o ′ ) ∼ D H ( 视频序列中的相邻时间步帧 )
输入与采样分布 :
D H \mathcal{D}_H D H ( o , o ′ , g ) (o, o', g) ( o , o ′ , g ) o o o o ′ o' o ′ g g g p ( g ) p(g) p ( g ) g g g μ 0 ( o , g ) \mu_0(o, g) μ 0 ( o , g )
奖励与价值函数 :
r ( o , g ) = δ g ~ ( o ) r(o,g) = \delta_{\tilde{g}}(o) r ( o , g ) = δ g ~ ( o ) o ≠ g o \neq g o = g − 1 -1 − 1 o = g o = g o = g 0 0 0 V ( ϕ ( o ) , ϕ ( g ) ) V(\phi(o), \phi(g)) V ( ϕ ( o ) , ϕ ( g )) o o o g g g γ ∈ ( 0 , 1 ) \gamma \in (0, 1) γ ∈ ( 0 , 1 )
隐式时间对比学习 (Implicit Time Contrastive Learning)
假设已获得最优价值函数V ∗ V^* V ∗ V ∗ ( ϕ ( o ) , ϕ ( g ) ) V^*(\phi(o), \phi(g)) V ∗ ( ϕ ( o ) , ϕ ( g ))
min ϕ ( 1 − γ ) E g ∼ p ( g ) , o ∼ μ 0 ( o , g ) [ − log exp ( V ∗ ( ϕ ( o ) , ϕ ( g ) ) ) E ( o , o ′ , g ) ∼ D H [ exp ( δ g ~ ( o ) + γ V ∗ ( ϕ ( o ′ ) , ϕ ( g ) ) − V ∗ ( ϕ ( o ) , ϕ ( g ) ) ) ] 1 1 − γ ] \begin{aligned} & \min_{\phi} (1-\gamma) \mathbb{E}_{g \sim p(g), o \sim \mu_0(o,g)} \left[ -\log \frac{\exp\left(V^*(\phi(o), \phi(g))\right)}{\mathbb{E}_{(o, o', g) \sim \mathcal{D}_H} \left[ \exp \left( \delta_{\tilde{g}}(o) + \gamma V^*(\phi(o'), \phi(g)) - V^*(\phi(o), \phi(g)) \right) \right]^{\frac{1}{1-\gamma}}} \right] \end{aligned} ϕ min ( 1 − γ ) E g ∼ p ( g ) , o ∼ μ 0 ( o , g ) [ − log E ( o , o ′ , g ) ∼ D H [ exp ( δ g ~ ( o ) + γ V ∗ ( ϕ ( o ′ ) , ϕ ( g )) − V ∗ ( ϕ ( o ) , ϕ ( g )) ) ] 1 − γ 1 exp ( V ∗ ( ϕ ( o ) , ϕ ( g )) ) ]
正负样本机制(推拉机制) :
正样本(拉近) :分子显式拉近初始帧o 0 ∼ μ 0 o_0 \sim \mu_0 o 0 ∼ μ 0 g g g 负样本(隐式排斥) :分母不包含显式的斥力项,而是要求最小化一步 Temporal-Difference (TD) 误差。因为V ∗ V^* V ∗ 自发涌现的隐式排斥(Emergent Implicit Repulsion) 。
局部平滑性 :相比传统 TCN(时间对比网络)存在大量局部极小值,VIP 学习到的嵌入在时间轴上具备严格的单调递减性与局部平滑性,便于直接提取下游控制奖励。
价值隐式预训练算法 (VIP)
VIP 采用非参数化设定:直接将最优价值函数V ∗ V^* V ∗ V ∗ ( ϕ ( o ) , ϕ ( g ) ) : = − ∥ ϕ ( o ) − ϕ ( g ) ∥ 2 V^*(\phi(o), \phi(g)) := -\Vert{}\phi(o) - \phi(g)\Vert{}_2 V ∗ ( ϕ ( o ) , ϕ ( g )) := − ∥ ϕ ( o ) − ϕ ( g ) ∥ 2
min ϕ L ( ϕ ) = ( 1 − γ ) E g ∼ p ( g ) , o ∼ μ 0 ( o , g ) [ ∥ ϕ ( o ) − ϕ ( g ) ∥ 2 ] + log E ( o , o ′ , g ) ∼ D H [ exp ( ∥ ϕ ( o ) − ϕ ( g ) ∥ 2 − δ g ~ ( o ) − γ ∥ ϕ ( o ′ ) − ϕ ( g ) ∥ 2 ) ] \begin{aligned} & \min_{\phi} \mathcal{L}(\phi) = (1-\gamma) \mathbb{E}_{g \sim p(g), o \sim \mu_0(o,g)} \left[ \Vert{}\phi(o) - \phi(g)\Vert{}_2 \right] \\ & \qquad + \log \mathbb{E}_{(o, o', g) \sim \mathcal{D}_H} \left[ \exp \left( \Vert{}\phi(o) - \phi(g)\Vert{}_2 - \delta_{\tilde{g}}(o) - \gamma \Vert{}\phi(o') - \phi(g)\Vert{}_2 \right) \right] \end{aligned} ϕ min L ( ϕ ) = ( 1 − γ ) E g ∼ p ( g ) , o ∼ μ 0 ( o , g ) [ ∥ ϕ ( o ) − ϕ ( g ) ∥ 2 ] + log E ( o , o ′ , g ) ∼ D H [ exp ( ∥ ϕ ( o ) − ϕ ( g ) ∥ 2 − δ g ~ ( o ) − γ ∥ ϕ ( o ′ ) − ϕ ( g ) ∥ 2 ) ]
从数据集D H \mathcal{D}_H D H B B B { ( o t i , o k i , o k + 1 i , o T i ) } i = 1 B \{ (o_t^i, o_k^i, o_{k+1}^i, o_T^i) \}_{i=1}^B {( o t i , o k i , o k + 1 i , o T i ) } i = 1 B o t i o_t^i o t i o T i o_T^i o T i g g g o k i , o k + 1 i o_k^i, o_{k+1}^i o k i , o k + 1 i
1: Require: Offline human video dataset D = { (o_1^i, ..., o_{h_i}^i) }_{i=1}^N, Visual encoder phi 2: for number of training iterations do 3: Sample sub-trajectories { (o_t^i, ..., o_k^i, o_{k+1}^i, ..., o_T^i) }_{i=1}^B ~ D where 1 <= t < k < T <= h_i 4: Compute loss L(phi): L(phi) = (1 - gamma) / B * sum_{i=1}^B [ || phi(o_t^i) - phi(o_T^i) ||_2 ] + log( 1 / B * sum_{i=1}^B [ exp( || phi(o_k^i) - phi(o_T^i) ||_2 - delta_{o_T^i}(o_k^i) - gamma * || phi(o_{k+1}^i) - phi(o_T^i) ||_2 ) ] ) 5: Update parameters: phi <- phi - alpha * grad(L(phi))