离散自回归动作 Token
OpenVLA: 一种开源的视觉-语言-动作模型
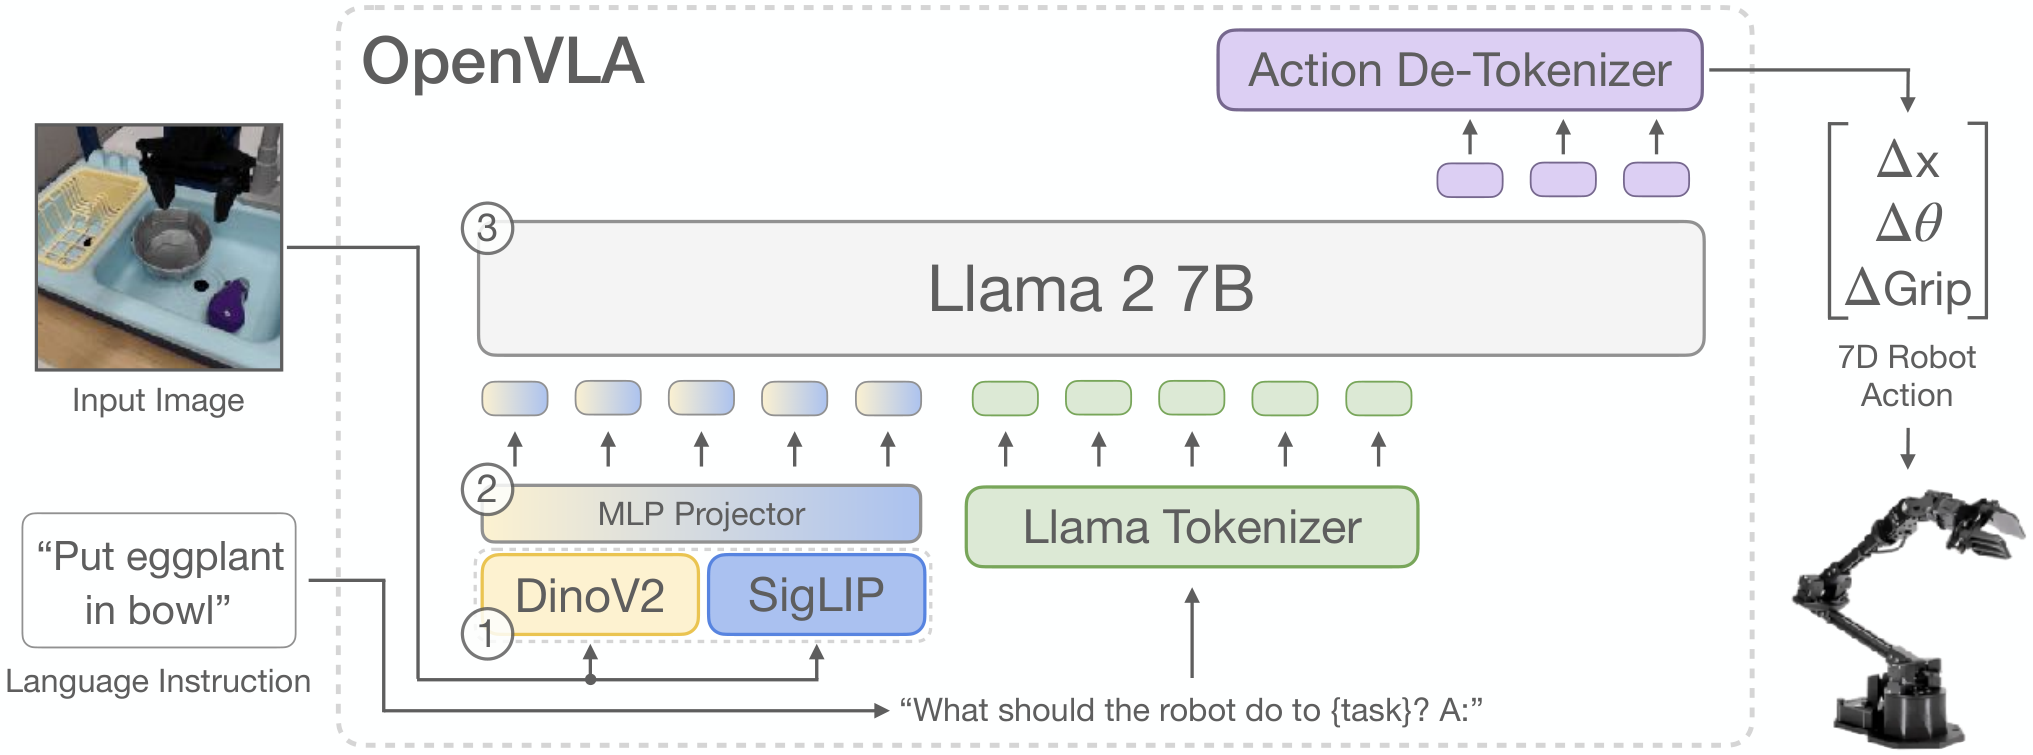
OpenVLA 模型是一个 7B 参数的视觉-语言-动作模型 (VLA),基于来自 Open X-Embodiment 数据集的 97 万个机器人演示进行训练。
OpenVLA 的核心思想是将机器人动作预测完全统一为视觉-语言任务 。它接受一张机器人当前看到的图片和一句文本指令,最终由大型语言模型(LLM)逐字输出机器人的动作指令。
第一步:视觉与文本输入的嵌入(Embedding)
模型首先接收一张当前摄像头拍摄的原始图像I I I L L L "Pick up the yellow mustard bottle")。
为了兼顾“高层语义”与“低层精准几何定位”,模型使用双流视觉编码器提取图像特征:
Input: I ∈ R H × W × C , L = ( w 1 , w 2 , … , w M ) E SigLIP ( I ) ∈ R N v × D 1 , E DinoV2 ( I ) ∈ R N v × D 2 Z v = [ E SigLIP ( I ) ∥ E DinoV2 ( I ) ] ∈ R N v × ( D 1 + D 2 ) X v = f MLP ( Z v ) ∈ R N v × D LLM X l = Embed LLM ( L ) ∈ R M × D LLM X = [ X v ∥ X l ] ∈ R ( N v + M ) × D LLM \begin{aligned} & \text{Input: } I \in \mathbb{R}^{H \times W \times C}, \quad L = (w_1, w_2, \dots, w_M) \\ & E_{\text{SigLIP}}(I) \in \mathbb{R}^{N_v \times D_1}, \quad E_{\text{DinoV2}}(I) \in \mathbb{R}^{N_v \times D_2} \\ & Z_v = \left[ E_{\text{SigLIP}}(I) \,\Vert{}\, E_{\text{DinoV2}}(I) \right] \in \mathbb{R}^{N_v \times (D_1 + D_2)} \\ & X_v = f_{\text{MLP}}(Z_v) \in \mathbb{R}^{N_v \times D_{\text{LLM}}} \\ & X_l = \text{Embed}_{\text{LLM}}(L) \in \mathbb{R}^{M \times D_{\text{LLM}}} \\ & X = [X_v \,\Vert{}\, X_l] \in \mathbb{R}^{(N_v + M) \times D_{\text{LLM}}} \end{aligned} Input: I ∈ R H × W × C , L = ( w 1 , w 2 , … , w M ) E SigLIP ( I ) ∈ R N v × D 1 , E DinoV2 ( I ) ∈ R N v × D 2 Z v = [ E SigLIP ( I ) ∥ E DinoV2 ( I ) ] ∈ R N v × ( D 1 + D 2 ) X v = f MLP ( Z v ) ∈ R N v × D LLM X l = Embed LLM ( L ) ∈ R M × D LLM X = [ X v ∥ X l ] ∈ R ( N v + M ) × D LLM
I ∈ R 224 × 224 × 3 I \in \mathbb{R}^{224 \times 224 \times 3} I ∈ R 224 × 224 × 3 224 × 224 224 \times 224 224 × 224 384 × 384 384 \times 384 384 × 384 L = ( w 1 , … , w M ) L = (w_1, \dots, w_M) L = ( w 1 , … , w M ) M M M E SigLIP , E DinoV2 E_{\text{SigLIP}}, E_{\text{DinoV2}} E SigLIP , E DinoV2 Z v Z_v Z v N v N_v N v f MLP f_{\text{MLP}} f MLP D LLM D_{\text{LLM}} D LLM X ∈ R ( N v + M ) × D LLM X \in \mathbb{R}^{(N_v + M) \times D_{\text{LLM}}} X ∈ R ( N v + M ) × D LLM X v X_v X v X l X_l X l
第二步:连续动作的离散化与词表映射(Action Discretization & Tokenization)
为了让只能输出文本词元(Text Tokens)的 LLM 能够输出机器人物理动作,需要将连续的物理动作向量转译为 LLM 能理解的离散 Token。
假设机器人当前需要执行的末端执行器动作向量为:
a = [ a 1 , a 2 , … , a N ] ⊤ ∈ R N \mathbf{a} = [a_1, a_2, \dots, a_N]^\top \in \mathbb{R}^N a = [ a 1 , a 2 , … , a N ] ⊤ ∈ R N
例如在 7 自由度机械臂控制中,N = 7 N=7 N = 7 Δ x , Δ y , Δ z \Delta x, \Delta y, \Delta z Δ x , Δ y , Δ z Δ roll , Δ pitch , Δ yaw \Delta \text{roll}, \Delta \text{pitch}, \Delta \text{yaw} Δ roll , Δ pitch , Δ yaw
量化与 Token 映射公式如下:
q 1 ( i ) = Percentile ( D , a i , 1 ) , q 99 ( i ) = Percentile ( D , a i , 99 ) a ~ i = Clip ( ⌊ 255 × a i − q 1 ( i ) q 99 ( i ) − q 1 ( i ) ⌋ , 0 , 255 ) ∈ { 0 , 1 , … , 255 } y a i = V LLM [ ∣ V LLM ∣ − 256 + a ~ i ] \begin{aligned} & q_1^{(i)} = \text{Percentile}(\mathcal{D}, a_i, 1), \quad q_{99}^{(i)} = \text{Percentile}(\mathcal{D}, a_i, 99) \\ & \tilde{a}_i = \text{Clip} \left( \left\lfloor 255 \times \frac{a_i - q_1^{(i)}}{q_{99}^{(i)} - q_1^{(i)}} \right\rfloor, \, 0, \, 255 \right) \in \{0, 1, \dots, 255\} \\ & y_{a_i} = V_{\text{LLM}}[\vert{}V_{\text{LLM}}\vert{} - 256 + \tilde{a}_i] \end{aligned} q 1 ( i ) = Percentile ( D , a i , 1 ) , q 99 ( i ) = Percentile ( D , a i , 99 ) a ~ i = Clip ( ⌊ 255 × q 99 ( i ) − q 1 ( i ) a i − q 1 ( i ) ⌋ , 0 , 255 ) ∈ { 0 , 1 , … , 255 } y a i = V LLM [ ∣ V LLM ∣ − 256 + a ~ i ]
q 1 ( i ) , q 99 ( i ) q_1^{(i)}, q_{99}^{(i)} q 1 ( i ) , q 99 ( i ) D \mathcal{D} D i i i a ~ i ∈ { 0 , 1 , … , 255 } \tilde{a}_i \in \{0, 1, \dots, 255\} a ~ i ∈ { 0 , 1 , … , 255 } i i i [ q 1 ( i ) , q 99 ( i ) ] [q_1^{(i)}, q_{99}^{(i)}] [ q 1 ( i ) , q 99 ( i ) ] V LLM V_{\text{LLM}} V LLM a ~ i \tilde{a}_i a ~ i y a i y_{a_i} y a i
为什么要计算第 1 与第 99 分位数分界线(q 1 ( i ) q_1^{(i)} q 1 ( i ) q 99 ( i ) q_{99}^{(i)} q 99 ( i ) :对连续的动作数值进行离散划分(量化),同时抵抗数据中的噪点和异常值。
为什么要划分 256 个区间? 0.0123 m 0.0123\text{m} 0.0123 m 0 ∼ 255 0 \sim 255 0 ∼ 255 为什么要用第 1 和第 99 分位数,而不是最小值和最大值(Min-Max)? Δ x = 10.0 \Delta x = 10.0 Δ x = 10.0 − 0.1 ∼ + 0.1 -0.1 \sim +0.1 − 0.1 ∼ + 0.1 q 1 ( i ) q_1^{(i)} q 1 ( i ) q 99 ( i ) q_{99}^{(i)} q 99 ( i )
划分 256 个区间而非其它数量区间的原因 256 256 256
为了引入全新的“动作 Token”,OpenVLA 遵循了 RT-2 等前作的惯例,直接覆盖 Llama 词汇表中最罕用/使用频率最低的最后 256 个 Token。如果设置成 1024 档,就需要覆盖原词表中过多有用的文本 Token,可能会损坏 LLM 原有的语言理解和推理能力;如果设置成 64 档,对 Token 空间的占用倒是小了,但又会牺牲控制精度。[ − 0.1 m , + 0.1 m ] [-0.1\text{m}, +0.1\text{m}] [ − 0.1 m , + 0.1 m ] 0.2 m 0.2\text{m} 0.2 m 200 mm 200\text{mm} 200 mm
如果设为 16 档:每个档位代表200 mm 16 = 12.5 mm \frac{200\text{mm}}{16} = 12.5\text{mm} 16 200 mm = 12.5 mm
如果设为 256 档:每个档位代表200 mm 256 ≈ 0.78 mm \frac{200\text{mm}}{256} \approx 0.78\text{mm} 256 200 mm ≈ 0.78 mm 1 mm 1\text{mm} 1 mm
如果设为 65,536 档(16-bit):精度虽然极高,但会给 LLM 的分类预测带来极大的学习难度。P ( y i ) = e z i ∑ j = 0 255 e z j P(y_i) = \frac{e^{z_i}}{\sum_{j=0}^{255} e^{z_j}} P ( y i ) = ∑ j = 0 255 e z j e z i
第三步:LLM 前向预测与训练目标(Autoregressive Action Prediction)
将拼接好的上下文序列X = [ X v ∥ X l ] X = [X_v \,\Vert{}\, X_l] X = [ X v ∥ X l ] N N N
P ( y a 1 , y a 2 , … , y a N ∣ X ) = ∏ i = 1 N P θ ( y a i ∣ y < a i , X ) P(y_{a_1}, y_{a_2}, \dots, y_{a_N} \mid X) = \prod_{i=1}^N P_\theta \left( y_{a_i} \mid y_{<a_i}, X \right) P ( y a 1 , y a 2 , … , y a N ∣ X ) = i = 1 ∏ N P θ ( y a i ∣ y < a i , X )
模型优化目标为仅对这N N N
L Action ( θ ) = − ∑ i = 1 N log P θ ( y a i ∣ y < a i , X ) \mathcal{L}_{\text{Action}}(\theta) = - \sum_{i=1}^N \log P_\theta \left( y_{a_i} \mid y_{<a_i}, X \right) L Action ( θ ) = − i = 1 ∑ N log P θ ( y a i ∣ y < a i , X )
在该训练阶段,关键的工程决策包括:
解冻(Unfreeze)并全程微调视觉编码器 :训练中解冻视觉编码器对捕捉细粒度空间几何细节至关重要,如果按照传统 VLM 做法冻结视觉编码器,会导致控制精度大幅下降。高 Epochs 充分训练 :全量迭代训练多达27 轮(Epochs) ,直到动作 Token 预测准确率超过 95%。学习率策略 :采用固定学习率η = 2 × 10 − 5 \eta = 2 \times 10^{-5} η = 2 × 1 0 − 5
第四步:推断时的动作解码(Action Inference / Unquantization)
在实际控制机器人时,模型输出N N N
a ^ i = q 1 ( i ) + a ~ i 255 ⋅ ( q 99 ( i ) − q 1 ( i ) ) \hat{a}_i = q_1^{(i)} + \frac{\tilde{a}_i}{255} \cdot \left( q_{99}^{(i)} - q_1^{(i)} \right) a ^ i = q 1 ( i ) + 255 a ~ i ⋅ ( q 99 ( i ) − q 1 ( i ) )
将还原出的a ^ = [ a ^ 1 , a ^ 2 , … , a ^ N ] ⊤ \hat{\mathbf{a}} = [\hat{a}_1, \hat{a}_2, \dots, \hat{a}_N]^\top a ^ = [ a ^ 1 , a ^ 2 , … , a ^ N ] ⊤ → \rightarrow →
附:训练数据的构建策略
为了让上述流程能泛化控制多种机器人形态,训练数据基于 Open X-Embodiment (OpenX) 跨具身数据集构建,通过严格的过滤机制与启发式重采样均衡形态分布:
D OpenVLA = ∑ k ∈ K filtered w k ⋅ D k s.t. K filtered = { k ∣ Camera ( k ) ≥ 1 (3rd-person) , Control ( k ) = Single-Arm EE } w k = f Octo ( Diversity ( k ) , Domain ( k ) ) \begin{aligned} & \mathcal{D}_{\text{OpenVLA}} = \sum_{k \in \mathcal{K}_{\text{filtered}}} w_k \cdot \mathcal{D}_k \\ & \text{s.t.} \\ & \quad \mathcal{K}_{\text{filtered}} = \{k \mid \text{Camera}(k) \ge 1 \text{ (3rd-person)}, \, \text{Control}(k) = \text{Single-Arm EE}\} \\ & \quad w_k = f_{\text{Octo}}(\text{Diversity}(k), \text{Domain}(k)) \end{aligned} D OpenVLA = k ∈ K filtered ∑ w k ⋅ D k s.t. K filtered = { k ∣ Camera ( k ) ≥ 1 (3rd-person) , Control ( k ) = Single-Arm EE } w k = f Octo ( Diversity ( k ) , Domain ( k ))
D k , w k \mathcal{D}_k, w_k D k , w k k k k K filtered \mathcal{K}_{\text{filtered}} K filtered f Octo f_{\text{Octo}} f Octo
FAST:面向视觉-语言-动作模型的高效动作标记化
本研究(Physical Intelligence 提出的 FAST 分词器)旨在解决高频机器人控制场景下,经典自回归 VLA 模型(如 OpenVLA、RT-2)采用“逐时间步分箱(Binning)分词”所导致的信息冗余、收敛缓慢以及高频控制性能急剧退化问题。
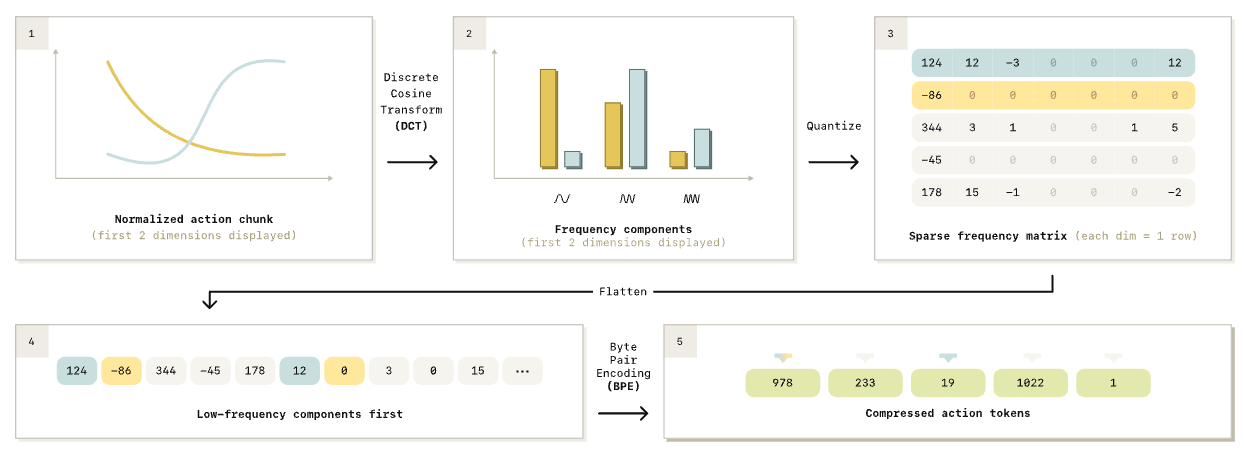
FAST 通过将时域连续动作块映射至频域(离散余弦变换 DCT),结合标量量化与字节对编码(BPE),实现了将高频动作块压缩为少量高效 Token 的端到端映射过程。
动作块预测任务界定
策略网络π ( a 1 : H ∣ o ) \pi(\mathbf{a}_{1:H} \mid o) π ( a 1 : H ∣ o ) o o o H H H a 1 : H \mathbf{a}_{1:H} a 1 : H
动作分词器T a \mathcal{T}_a T a
T a : a 1 : H ∈ R H × ∣ A ∣ ⟶ [ T 1 , T 2 , … , T n ] , T i ∈ { 1 , 2 , … , ∣ V ∣ } \mathcal{T}_a: \mathbf{a}_{1:H} \in \mathbb{R}^{H \times |\mathcal{A}|} \longrightarrow [T_1, T_2, \dots, T_n], \quad T_i \in \{1, 2, \dots, |\mathcal{V}|\} T a : a 1 : H ∈ R H × ∣ A ∣ ⟶ [ T 1 , T 2 , … , T n ] , T i ∈ { 1 , 2 , … , ∣ V ∣ }
a 1 : H = [ a 1 , a 2 , … , a H ] ⊤ ∈ R H × D \mathbf{a}_{1:H} = [\mathbf{a}_1, \mathbf{a}_2, \dots, \mathbf{a}_H]^\top \in \mathbb{R}^{H \times D} a 1 : H = [ a 1 , a 2 , … , a H ] ⊤ ∈ R H × D H H H D = ∣ A ∣ D = |\mathcal{A}| D = ∣ A ∣ ∣ V ∣ |\mathcal{V}| ∣ V ∣ n n n n n n
经典逐时间步分箱(Naive Per-Timestep Binning)缺陷
经典方法(如 OpenVLA、RT-2)将每个时间步t ∈ [ 1 , H ] t \in [1, H] t ∈ [ 1 , H ] d ∈ [ 1 , D ] d \in [1, D] d ∈ [ 1 , D ] N = 256 N=256 N = 256 n = H × D n = H \times D n = H × D
T Binning ( a 1 : H ) = [ T 1 , 1 , … , T 1 , D , T 2 , 1 , … , T 2 , D , … , T H , 1 , … , T H , D ] \mathcal{T}_{\text{Binning}}(\mathbf{a}_{1:H}) = [T_{1,1}, \dots, T_{1,D}, \; T_{2,1}, \dots, T_{2,D}, \; \dots, \; T_{H,1}, \dots, T_{H,D}] T Binning ( a 1 : H ) = [ T 1 , 1 , … , T 1 , D , T 2 , 1 , … , T 2 , D , … , T H , 1 , … , T H , D ] 对自回归模型而言,下一个 Token 的学习信号强度取决于给定历史条件下的边际信息增量(Conditional Entropy / Information Gain):
I ( T i ∣ T 1 : i − 1 ) \mathcal{I}(T_i \mid T_{1:i-1}) I ( T i ∣ T 1 : i − 1 )
在连续平滑动作信号下,当采样频率提升(即时间步长Δ t → 0 \Delta t \to 0 Δ t → 0
lim Δ t → 0 ∥ a t + 1 − a t ∥ = 0 ⟹ I ( T t + 1 , d ∣ T 1 : t , d ) → 0 \lim_{\Delta t \to 0} \|\mathbf{a}_{t+1} - \mathbf{a}_t\| = 0 \implies \mathcal{I}(T_{t+1, d} \mid T_{1:t, d}) \to 0 Δ t → 0 lim ∥ a t + 1 − a t ∥ = 0 ⟹ I ( T t + 1 , d ∣ T 1 : t , d ) → 0
连续相邻时间步的 Token 强高度相关,导致每个 Token 包含的边际信息量趋近于零。这使得自回归模型梯度收敛极慢,在高频数据(如 DROID 数据集,50Hz)训练时极易退化为简单重复预测首个动作(Copying First Action),使得预测均方误差(MSE)急剧上升。
FAST 频域动作压缩全流程 (The FAST Tokenization Pipeline)
FAST 的核心思想是利用频域变换(DCT)去除连续时域信号的高频冗余,仅提取表征轨迹整体形状的低频系数,再通过 BPE 实现进一步无损压缩。
第一步:分位数归一化 (Percentile Normalization)
对输入动作块a 1 : H \mathbf{a}_{1:H} a 1 : H d ∈ { 1 , … , D } d \in \{1, \dots, D\} d ∈ { 1 , … , D } [ − 1 , 1 ] [-1, 1] [ − 1 , 1 ]
a ˉ t , d = Clip ( 2 ⋅ a t , d − q 1 ( d ) q 99 ( d ) − q 1 ( d ) − 1 , − 1 , 1 ) , ∀ t ∈ { 1 , … , H } \bar{a}_{t, d} = \text{Clip}\left( 2 \cdot \frac{a_{t, d} - q_1^{(d)}}{q_{99}^{(d)} - q_1^{(d)}} - 1, \, -1, \, 1 \right), \quad \forall t \in \{1, \dots, H\} a ˉ t , d = Clip ( 2 ⋅ q 99 ( d ) − q 1 ( d ) a t , d − q 1 ( d ) − 1 , − 1 , 1 ) , ∀ t ∈ { 1 , … , H }
q 1 ( d ) , q 99 ( d ) q_1^{(d)}, q_{99}^{(d)} q 1 ( d ) , q 99 ( d ) d d d A ˉ ∈ R H × D \bar{\mathbf{A}} \in \mathbb{R}^{H \times D} A ˉ ∈ R H × D
沿时间轴(长度为H H H A ˉ \bar{\mathbf{A}} A ˉ d d d
C k , d = w ( k ) ∑ t = 1 H a ˉ t , d cos ( π ( 2 t − 1 ) ( k − 1 ) 2 H ) , k ∈ { 1 , … , H } C_{k, d} = w(k) \sum_{t=1}^{H} \bar{a}_{t, d} \cos \left( \frac{\pi (2t - 1) (k - 1)}{2H} \right), \quad k \in \{1, \dots, H\} C k , d = w ( k ) t = 1 ∑ H a ˉ t , d cos ( 2 H π ( 2 t − 1 ) ( k − 1 ) ) , k ∈ { 1 , … , H } w ( k ) = { 1 H , k = 1 (直流分量 DC, 表征整体均值) 2 H , 2 ≤ k ≤ H (交流分量 AC, 由低到高频) w(k) = \begin{cases}
\frac{1}{\sqrt{H}}, & k = 1 \text{ (直流分量 DC, 表征整体均值)} \\
\sqrt{\frac{2}{H}}, & 2 \le k \le H \text{ (交流分量 AC, 由低到高频)}
\end{cases} w ( k ) = ⎩ ⎨ ⎧ H 1 , H 2 , k = 1 ( 直流分量 DC, 表征整体均值 ) 2 ≤ k ≤ H ( 交流分量 AC, 由低到高频 )
C k , d C_{k, d} C k , d d d d k k k C ∈ R H × D \mathbf{C} \in \mathbb{R}^{H \times D} C ∈ R H × D k k k k k k
第三步:标量量化与稀疏化 (Quantization & Rounding)
利用缩放因子γ \gamma γ C \mathbf{C} C
C ˉ k , d = Round ( γ ⋅ C k , d ) ∈ Z \bar{C}_{k, d} = \text{Round}\left( \gamma \cdot C_{k, d} \right) \in \mathbb{Z} C ˉ k , d = Round ( γ ⋅ C k , d ) ∈ Z
γ \gamma γ γ = 10 \gamma = 10 γ = 10 C ˉ ∈ Z H × D \bar{\mathbf{C}} \in \mathbb{Z}^{H \times D} C ˉ ∈ Z H × D
第四步:列优先展平与 BPE 无损压缩 (Column-Major Flattening & BPE)
列优先展平 (Column-Major Flattening) :
为了让自回归模型在预测时首先生成对轨迹整体形状影响最大的低频分量,对矩阵C ˉ \bar{\mathbf{C}} C ˉ
S flat = [ C ˉ 1 , 1 , C ˉ 1 , 2 , … , C ˉ 1 , D , C ˉ 2 , 1 , C ˉ 2 , 2 , … , C ˉ 2 , D , … , C ˉ H , 1 , … , C ˉ H , D ] \mathbf{S}_{\text{flat}} = [\bar{C}_{1,1}, \bar{C}_{1,2}, \dots, \bar{C}_{1,D}, \; \bar{C}_{2,1}, \bar{C}_{2,2}, \dots, \bar{C}_{2,D}, \; \dots, \; \bar{C}_{H,1}, \dots, \bar{C}_{H,D}] S flat = [ C ˉ 1 , 1 , C ˉ 1 , 2 , … , C ˉ 1 , D , C ˉ 2 , 1 , C ˉ 2 , 2 , … , C ˉ 2 , D , … , C ˉ H , 1 , … , C ˉ H , D ]
BPE 算法压缩 (Byte-Pair Encoding) :
训练一个词汇表大小为∣ V BPE ∣ |\mathcal{V}_{\text{BPE}}| ∣ V BPE ∣ ϕ \phi ϕ
[ T 1 , T 2 , … , T n ] = BPE-Encode ( S flat , ϕ ) [T_1, T_2, \dots, T_n] = \text{BPE-Encode}\left( \mathbf{S}_{\text{flat}}, \, \phi \right) [ T 1 , T 2 , … , T n ] = BPE-Encode ( S flat , ϕ )
n ≪ H × D n \ll H \times D n ≪ H × D
第五步:动作解码与反量化 (Action Decoding & Inverse DCT)
在 VLA 模型推断出 Token 序列[ T 1 , … , T n ] [T_1, \dots, T_n] [ T 1 , … , T n ]
BPE 解码 :S flat = BPE-Decode ( [ T 1 , … , T n ] , ϕ ) \mathbf{S}_{\text{flat}} = \text{BPE-Decode}([T_1, \dots, T_n], \phi) S flat = BPE-Decode ([ T 1 , … , T n ] , ϕ ) 重构频域矩阵 :将一维序列按列优先还原为矩阵C ˉ ∈ Z H × D \bar{\mathbf{C}} \in \mathbb{Z}^{H \times D} C ˉ ∈ Z H × D 反量化 :C ^ k , d = C ˉ k , d γ \hat{C}_{k, d} = \frac{\bar{C}_{k, d}}{\gamma} C ^ k , d = γ C ˉ k , d 逆离散余弦变换 (IDCT) :
a ^ t , d = ∑ k = 1 H w ( k ) C ^ k , d cos ( π ( 2 t − 1 ) ( k − 1 ) 2 H ) \hat{a}_{t, d} = \sum_{k=1}^{H} w(k) \hat{C}_{k, d} \cos \left( \frac{\pi (2t - 1) (k - 1)}{2H} \right) a ^ t , d = k = 1 ∑ H w ( k ) C ^ k , d cos ( 2 H π ( 2 t − 1 ) ( k − 1 ) ) 反归一化 :
a t , d pred = q 1 ( d ) + a ^ t , d + 1 2 ( q 99 ( d ) − q 1 ( d ) ) a_{t, d}^{\text{pred}} = q_1^{(d)} + \frac{\hat{a}_{t, d} + 1}{2} \left( q_{99}^{(d)} - q_1^{(d)} \right) a t , d pred = q 1 ( d ) + 2 a ^ t , d + 1 ( q 99 ( d ) − q 1 ( d ) )
算法实现与通用动作分词器 (FAST Algorithm & FAST+)
归一化输入动作块,得到范围在[ − 1 , 1 ] [-1, 1] [ − 1 , 1 ] A ˉ \bar{\mathbf{A}} A ˉ
对每个动作维度沿时间轴独立执行 1D-DCT,提取频域矩阵C \mathbf{C} C
应用缩放因子γ \gamma γ C ˉ \bar{\mathbf{C}} C ˉ
按列优先(低频优先)交错顺序展开为一维整数数组S flat \mathbf{S}_{\text{flat}} S flat
通过训练好的 BPE 编码器将稀疏整数序列压缩成固定词表范围内的离散 Token 序列[ T 1 , … , T n ] [T_1, \dots, T_n] [ T 1 , … , T n ]
为了消除针对每个新机器人数据集重新训练 BPE 词汇表的时间开销,作者在包含单臂、双手及移动操作机器人的100 万条 1 秒长动作片段(包含 Joint 与 End-Effector 空间,涵盖 10Hz~50Hz 各种频率) 的跨具身混合数据集上,训练了通用动作分词器FAST+ 。
FAST+ 可作为开箱即用的黑盒分词器直接应用于任意全新机器人形态。
Diffusion Action Policy
Octo:一款开源通用机器人策略
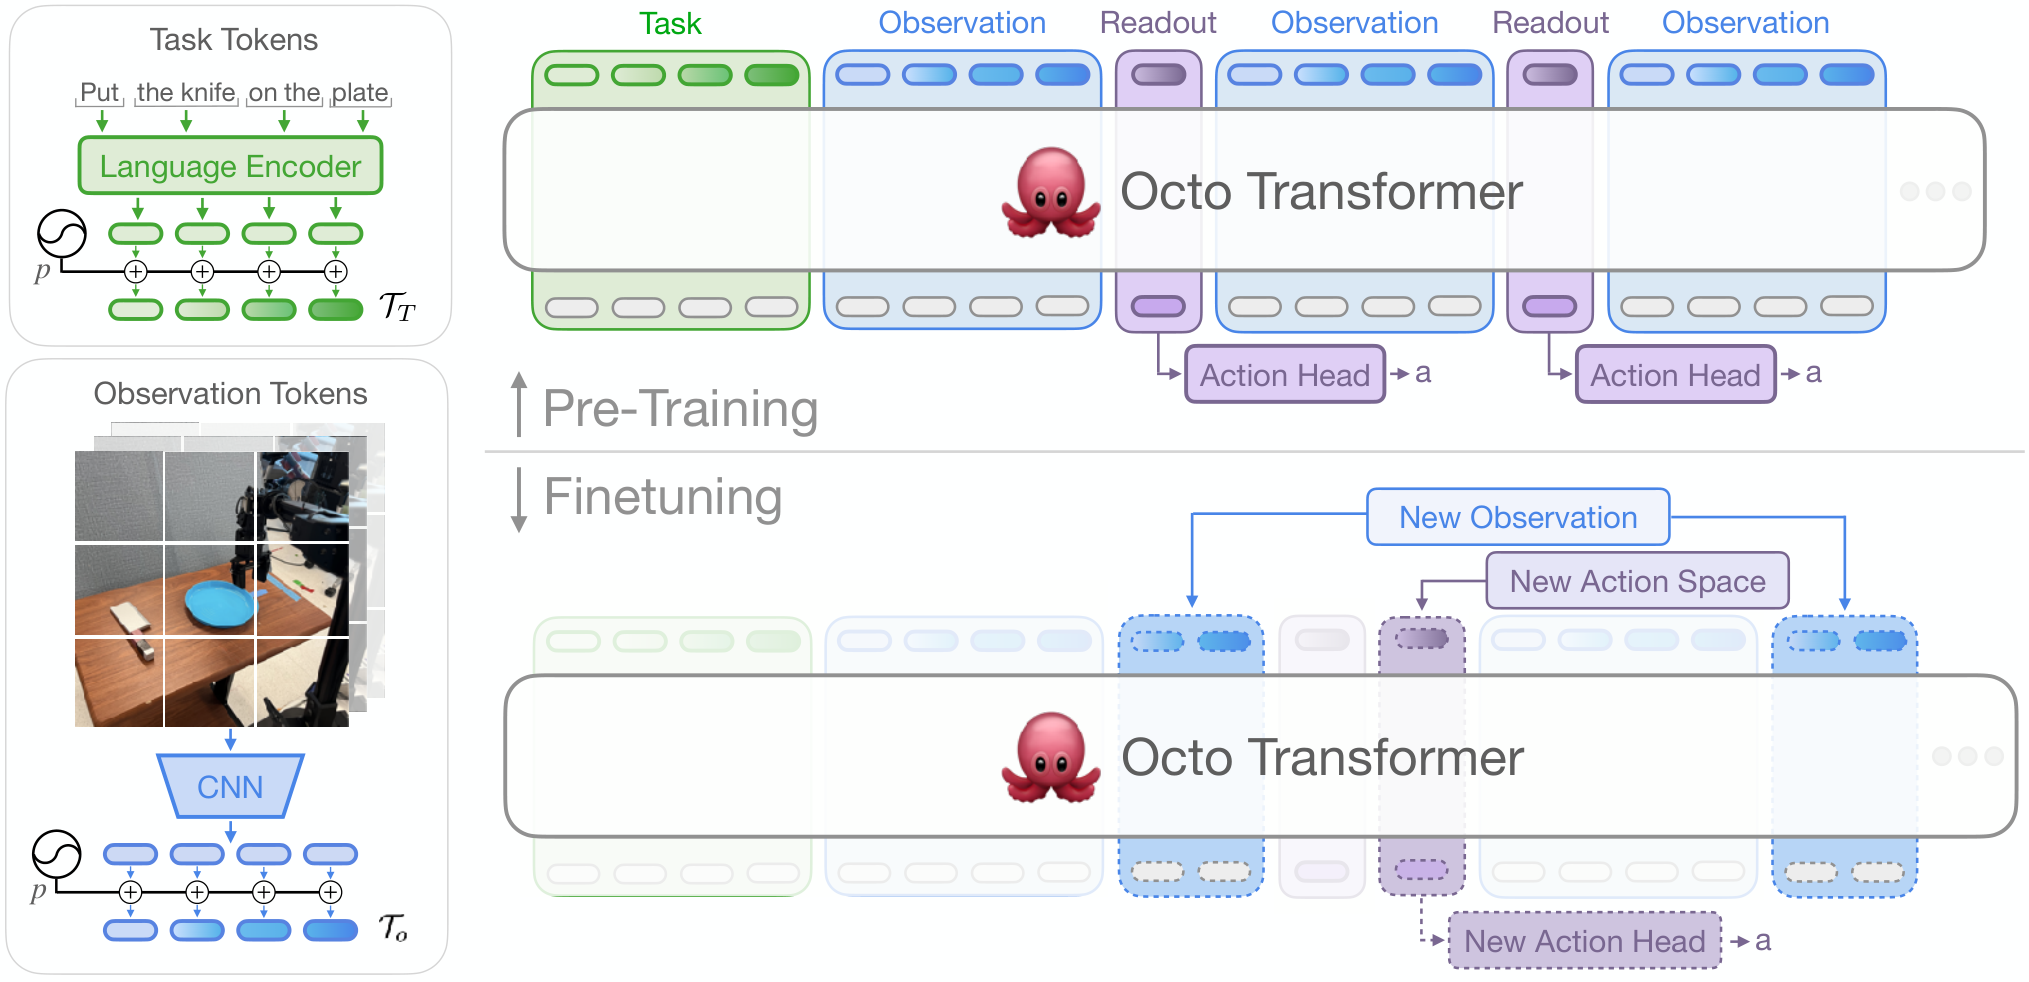
Octo 是一个开源的通用机器人策略(Generalist Robot Policy),其核心设计思想是通过统一标记化(Tokenization) 、模块化 Transformer 骨干网 与轻量级扩散解码头(Diffusion Readout Head) ,实现跨不同机器人形态、传感器配置(摄像头与本体感觉)和动作空间的端到端控制与高效微调。
任务与多模态输入标记化 (Task & Observation Tokenization)
Octo 将包含自然语言指令ℓ \ell ℓ g g g o 1 : H \mathbf{o}_{1:H} o 1 : H
T lang = E T5 ( ℓ ) ∈ R L × D model T img ( v , t ) = Patchify ( ConvStack ( I t ( v ) ) ) ∈ R P × D model , v ∈ { wrist , 3rd-person , … } , t ∈ { 1 , … , H } T goal = Patchify ( ConvStack ( I g ) ) ∈ R P × D model z in = [ T lang ∥ T goal ∥ T img ( 1 , 1 ) ∥ … ∥ T img ( V , H ) ∥ T read , 1 ∥ … ∥ T read , H ] + P pos \begin{aligned} & \mathcal{T}_{\text{lang}} = E_{\text{T5}}(\ell) \in \mathbb{R}^{L \times D_{\text{model}}} \\ & \mathcal{T}_{\text{img}}^{(v, t)} = \text{Patchify}\left(\text{ConvStack}(I_t^{(v)})\right) \in \mathbb{R}^{P \times D_{\text{model}}}, \quad v \in \{\text{wrist}, \text{3rd-person}, \dots\}, \quad t \in \{1, \dots, H\} \\ & \mathcal{T}_{\text{goal}} = \text{Patchify}\left(\text{ConvStack}(I_g)\right) \in \mathbb{R}^{P \times D_{\text{model}}} \\ & \mathbf{z}_{\text{in}} = \left[ \mathcal{T}_{\text{lang}} \,\Vert{}\, \mathcal{T}_{\text{goal}} \,\Vert{}\, \mathcal{T}_{\text{img}}^{(1, 1)} \,\Vert{}\, \dots \,\Vert{}\, \mathcal{T}_{\text{img}}^{(V, H)} \,\Vert{}\, \mathcal{T}_{\text{read}, 1} \,\Vert{}\, \dots \,\Vert{}\, \mathcal{T}_{\text{read}, H} \right] + \mathbf{P}_{\text{pos}} \end{aligned} T lang = E T5 ( ℓ ) ∈ R L × D model T img ( v , t ) = Patchify ( ConvStack ( I t ( v ) ) ) ∈ R P × D model , v ∈ { wrist , 3rd-person , … } , t ∈ { 1 , … , H } T goal = Patchify ( ConvStack ( I g ) ) ∈ R P × D model z in = [ T lang ∥ T goal ∥ T img ( 1 , 1 ) ∥ … ∥ T img ( V , H ) ∥ T read , 1 ∥ … ∥ T read , H ] + P pos
ℓ \ell ℓ E T5 E_{\text{T5}} E T5 L L L T lang \mathcal{T}_{\text{lang}} T lang I t ( v ) ∈ R H i × W i × C I_t^{(v)} \in \mathbb{R}^{H_i \times W_i \times C} I t ( v ) ∈ R H i × W i × C t t t v v v I g I_g I g ConvStack \text{ConvStack} ConvStack Patchify \text{Patchify} Patchify P P P D model D_{\text{model}} D model H H H H = 2 H=2 H = 2 T read , t ∈ R 1 × D model \mathcal{T}_{\text{read}, t} \in \mathbb{R}^{1 \times D_{\text{model}}} T read , t ∈ R 1 × D model 可学习读取 Token(Readout Tokens) ,对应时间步t t t P pos \mathbf{P}_{\text{pos}} P pos
统一 Token 序列z in \mathbf{z}_{\text{in}} z in
E = Transformer ( z in , M ) ∈ R N tokens × D model \mathbf{E} = \text{Transformer}(\mathbf{z}_{\text{in}}, \mathbf{M}) \in \mathbb{R}^{N_{\text{tokens}} \times D_{\text{model}}} E = Transformer ( z in , M ) ∈ R N tokens × D model
注意力掩蔽矩阵M \mathbf{M} M
因果约束(Causal Constraint) :观察 TokenT img ( v , t ) \mathcal{T}_{\text{img}}^{(v, t)} T img ( v , t ) ≤ t \le t ≤ t T lang , T goal \mathcal{T}_{\text{lang}}, \mathcal{T}_{\text{goal}} T lang , T goal 读取 Token 隔离约束(Readout Token Isolation) :读取 TokenT read , t \mathcal{T}_{\text{read}, t} T read , t 任何观察 Token 与任务 Token 均不可关注读取 Token 。读取 Token 类似 BERT 的[CLS] 标记,只被动聚合时域语义,不破坏原始特征。缺失模态掩蔽(Missing Modality Masking) :对于缺失摄像头视角或无语言标注的数据集样本,其对应的输入 Token 被完全屏蔽(Fully Masked),避免影响模型参数传播。
分块注意力掩蔽的实现与目的
观察块(Observation Blocks):机器人第t t t ≤ t \le t ≤ t t + 1 t+1 t + 1
读取 Token(Readout Tokens):它像是一个“只许听不许说”的旁听生。它可以看自己当前和之前的所有观察画面、任务指令,但所有的观察画面和指令,绝对不能看这个读取 Token。
缺失模态块(Missing Modality Blocks):如果某个数据集根本没有手腕摄像头,或者没有语言指令,这些缺失的数据块在掩蔽矩阵里就会被完全遮挡(Mask 为 0),相当于直接在模型里“隐身”。
实现“单向偷听”,安全提取控制特征:Octo 把过去所有的画面和任务指令融合压缩成一个精炼的向量(类似于 BERT 里的 [CLS] 标记),然后直接丢给后面的动作头去解算动作,既不破坏前面的特征表达,又提取到了最纯粹的决策信息。
极强的主插拔灵活性(插件化):传统的模型(如 OpenVLA)如果预训练时用了“主摄像头+手腕摄像头”,微调时想加一个“力矩传感器”,就必须把整个网络结构改掉、重新初始化训练。而 Octo 这种分块掩蔽机制,把输入变成了“拼图”。微调时想加一个力矩传感器,只需要在输入序列里追加一个新 Token 块,并为它配置一条掩蔽规则,预训练好的 Transformer 主干网权重完全不需要破坏或重新初始化,直接像插拔 U 盘一样即插即用。
扩散解码动作头与连续动作块预测 (Diffusion Readout Head & Chunked Action Prediction)
Octo 从读取 Token 得到的输出嵌入e t = E [ T read , t ] ∈ R D model \mathbf{e}_t = \mathbf{E}[\mathcal{T}_{\text{read}, t}] \in \mathbb{R}^{D_{\text{model}}} e t = E [ T read , t ] ∈ R D model
a t : t + K − 1 ∼ p θ ( a t : t + K − 1 ∣ e t ) x K ∼ N ( 0 , I ) For k = K , K − 1 , … , 1 : x k − 1 = 1 α k ( x k − 1 − α k 1 − α ˉ k ϵ θ ( x k , e t , k ) ) + σ k z , z ∼ N ( 0 , I ) a ^ t : t + K − 1 = x 0 ∈ R K × D action \begin{aligned} & \mathbf{a}_{t:t+K-1} \sim p_\theta(\mathbf{a}_{t:t+K-1} \mid \mathbf{e}_t) \\ & \mathbf{x}_K \sim \mathcal{N}(\mathbf{0}, \mathbf{I}) \\ & \text{For } k = K, K-1, \dots, 1: \\ & \quad \mathbf{x}_{k-1} = \frac{1}{\sqrt{\alpha_k}} \left( \mathbf{x}_k - \frac{1 - \alpha_k}{\sqrt{1 - \bar{\alpha}_k}} \boldsymbol{\epsilon}_\theta(\mathbf{x}_k, \mathbf{e}_t, k) \right) + \sigma_k \mathbf{z}, \quad \mathbf{z} \sim \mathcal{N}(\mathbf{0}, \mathbf{I}) \\ & \hat{\mathbf{a}}_{t:t+K-1} = \mathbf{x}_0 \in \mathbb{R}^{K \times D_{\text{action}}} \end{aligned} a t : t + K − 1 ∼ p θ ( a t : t + K − 1 ∣ e t ) x K ∼ N ( 0 , I ) For k = K , K − 1 , … , 1 : x k − 1 = α k 1 ( x k − 1 − α ˉ k 1 − α k ϵ θ ( x k , e t , k ) ) + σ k z , z ∼ N ( 0 , I ) a ^ t : t + K − 1 = x 0 ∈ R K × D action
训练目标 (DDPM Objective)
去噪网络ϵ θ \boldsymbol{\epsilon}_\theta ϵ θ
L Diffusion ( θ ) = E k ∼ U ( 1 , K ) , ϵ ∼ N ( 0 , I ) , ( a , e ) [ ∥ ϵ − ϵ θ ( α ˉ k a t : t + K − 1 + 1 − α ˉ k ϵ , e t , k ) ∥ 2 2 ] \mathcal{L}_{\text{Diffusion}}(\theta) = \mathbb{E}_{k \sim U(1, K), \boldsymbol{\epsilon} \sim \mathcal{N}(\mathbf{0}, \mathbf{I}), (\mathbf{a}, \mathbf{e})} \left[ \left\Vert{} \boldsymbol{\epsilon} - \boldsymbol{\epsilon}_\theta\left( \sqrt{\bar{\alpha}_k}\mathbf{a}_{t:t+K-1} + \sqrt{1 - \bar{\alpha}_k}\boldsymbol{\epsilon}, \, \mathbf{e}_t, \, k \right) \right\Vert{}_2^2 \right] L Diffusion ( θ ) = E k ∼ U ( 1 , K ) , ϵ ∼ N ( 0 , I ) , ( a , e ) [ ϵ − ϵ θ ( α ˉ k a t : t + K − 1 + 1 − α ˉ k ϵ , e t , k ) 2 2 ]
a t : t + K − 1 ∈ R K × D action \mathbf{a}_{t:t+K-1} \in \mathbb{R}^{K \times D_{\text{action}}} a t : t + K − 1 ∈ R K × D action t t t K K K x k \mathbf{x}_k x k k k k K K K ϵ θ \boldsymbol{\epsilon}_\theta ϵ θ e t \mathbf{e}_t e t k k k x k \mathbf{x}_k x k α k , α ˉ k , σ k \alpha_k, \bar{\alpha}_k, \sigma_k α k , α ˉ k , σ k
扩散解码动作头与连续动作块预测 K K K
扩散的开始(起点k = K k=K k = K x K ∼ N ( 0 , I ) \mathbf{x}_K \sim \mathcal{N}(\mathbf{0}, \mathbf{I}) x K ∼ N ( 0 , I )
一步步去噪(中间过程k → 0 k \to 0 k → 0 ϵ θ \boldsymbol{\epsilon}_\theta ϵ θ x k \mathbf{x}_k x k e \mathbf{e} e x k − 1 \mathbf{x}_{k-1} x k − 1 K K K
扩散的结束(终点k = 0 k=0 k = 0 K K K x 0 \mathbf{x}_0 x 0 a ^ t : t + K − 1 \hat{\mathbf{a}}_{t:t+K-1} a ^ t : t + K − 1 e \mathbf{e} e
训练时输入的数据是什么 a \mathbf{a} a
提取真值:从机器人训练数据集中取出当前时间步真实的未来动作块a real \mathbf{a}_{\text{real}} a real
随机加噪:随机挑选一个去噪步数k k k k = 45 k=45 k = 45 ϵ \boldsymbol{\epsilon} ϵ x k = α ˉ k a real + 1 − α ˉ k ϵ \mathbf{x}_k = \sqrt{\bar{\alpha}_k} \mathbf{a}_{\text{real}} + \sqrt{1 - \bar{\alpha}_k} \boldsymbol{\epsilon} x k = α ˉ k a real + 1 − α ˉ k ϵ
前向与 Loss 计算:将这个带噪动作x k \mathbf{x}_k x k k k k e \mathbf{e} e ϵ θ \boldsymbol{\epsilon}_\theta ϵ θ ϵ \boldsymbol{\epsilon} ϵ ∥ ϵ − ϵ θ ( x k , e , k ) ∥ 2 \Vert{}\boldsymbol{\epsilon} - \boldsymbol{\epsilon}_\theta(\mathbf{x}_k, \mathbf{e}, k)\Vert{}^2 ∥ ϵ − ϵ θ ( x k , e , k ) ∥ 2
预训练数据流与微调范式 (Training Data Curation & Downstream Adaptation)
数据集重采样与动作空间统一
预训练基于 Open X-Embodiment 中精选的 25 个子数据集,处理逻辑如下:
筛选过滤 :仅保留包含图像流并采用 Delta 末端执行器(Delta End-Effector)控制的数据集,剔除无图像、非 Delta 控制及小众极度重复数据集。动作空间标准化 :将所有数据集的夹爪控制指令归一化为连续标量,使得+ 1 +1 + 1 0 0 0 启发式加权采样 :将数据集划分为高多样性与低多样性两类,高多样性数据集采样的批次权重翻倍;对无语言标签的数据集随机采用 100% 事后目标图像重标记(Hindsight Goal Relabeling)条件化。
下游极简高效微调 (Downstream Fine-Tuning)
在 downstream 迁移至新机器人形态、新传感器输入(如增加力矩传感器输入)或新动作空间(如关节位置控制)时,得益于分块掩蔽与读取 Token 设计:
完全保留 Transformer 骨干网预训练权重 ,仅针对新引入的传感器输入添加浅层编码器/位置编码,或针对新动作空间/损失函数挂载新的读取头。全参数端到端更新 :使用余弦衰减学习率与线性预热(Linear Warmup),在约 100 条下游目标轨迹上微调 50,000 步,全参数更新效果显著优于冻结部分骨干网参数。
三维扩散策略 (3D Diffusion Policy)
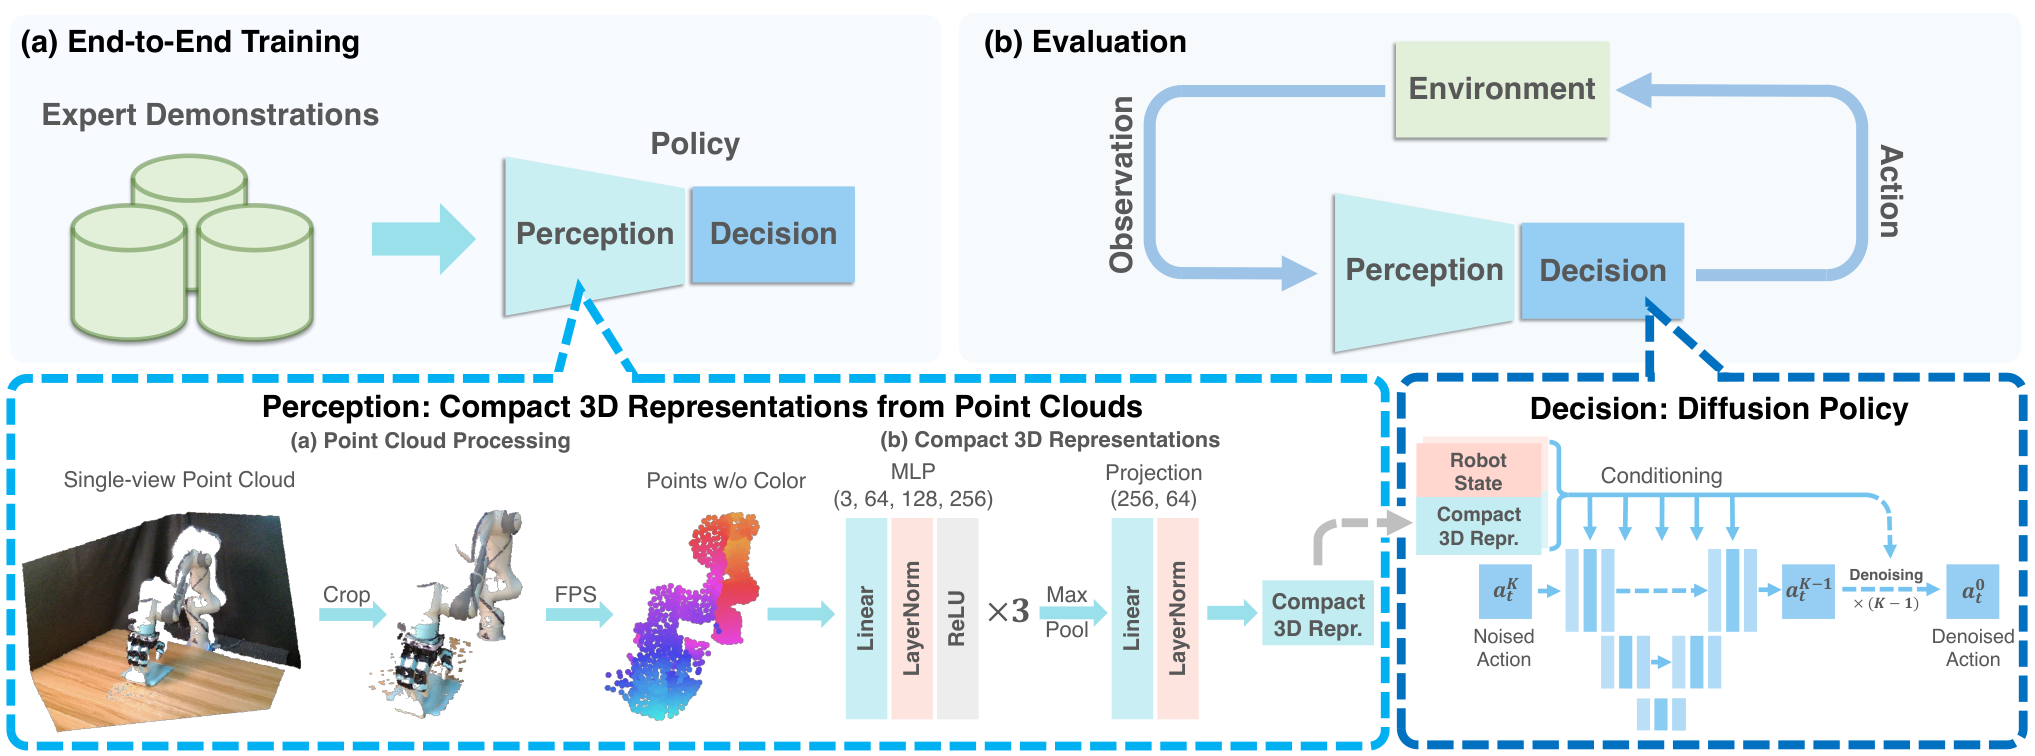
DP3 (3D Diffusion Policy) 旨在仅通过少量专家演示(如 5 条演示),学习一个能精准泛化至 3D 物理空间的视觉运动策略π : O ↦ A \pi: \mathcal{O} \mapsto \mathcal{A} π : O ↦ A
系统整体从单视角深度相机观测(RGB-D 或单深度图)出发,将其转化为稀疏点云,经轻量级点编码器提炼为紧凑的 3D 视觉特征向量,最后以此特征和机器人自身状态为条件,利用条件扩散过程去噪生成连续动作序列。
3D 视觉感知与特征提取 (3D Perception & Feature Encoding)
单视角点云生成与预处理
系统仅接收单个摄像头拍摄的低分辨率深度图像(如84 × 84 84 \times 84 84 × 84 K ∈ R 3 × 3 \mathbf{K} \in \mathbb{R}^{3 \times 3} K ∈ R 3 × 3 [ R ∣ t ] ∈ R 3 × 4 [\mathbf{R} \mid \mathbf{t}] \in \mathbb{R}^{3 \times 4} [ R ∣ t ] ∈ R 3 × 4 P raw \mathbf{P}_{\text{raw}} P raw
为了去除桌尾、地面等环境背景冗余并减小数据随机性,对点云进行空间裁剪 与最远点采样 (FPS) :
P raw = Backproject ( D , K , [ R ∣ t ] ) ∈ R N raw × 3 P crop = { p i ∈ P raw ∣ p min ≤ p i ≤ p max } ∈ R N crop × 3 P = FPS ( P crop , N ) ∈ R N × 3 \begin{aligned}
& \mathbf{P}_{\text{raw}} = \text{Backproject}(D, \mathbf{K}, [\mathbf{R} \mid \mathbf{t}]) \in \mathbb{R}^{N_{\text{raw}} \times 3} \\
& \mathbf{P}_{\text{crop}} = \{ \mathbf{p}_i \in \mathbf{P}_{\text{raw}} \mid \mathbf{p}_{\text{min}} \le \mathbf{p}_i \le \mathbf{p}_{\text{max}} \} \in \mathbb{R}^{N_{\text{crop}} \times 3} \\
& \mathbf{P} = \text{FPS}(\mathbf{P}_{\text{crop}}, N) \in \mathbb{R}^{N \times 3}
\end{aligned} P raw = Backproject ( D , K , [ R ∣ t ]) ∈ R N raw × 3 P crop = { p i ∈ P raw ∣ p min ≤ p i ≤ p max } ∈ R N crop × 3 P = FPS ( P crop , N ) ∈ R N × 3
D ∈ R H × W D \in \mathbb{R}^{H \times W} D ∈ R H × W H × W = 84 × 84 H \times W = 84 \times 84 H × W = 84 × 84 p i = [ x i , y i , z i ] ⊤ \mathbf{p}_i = [x_i, y_i, z_i]^\top p i = [ x i , y i , z i ] ⊤ [ p min , p max ] [\mathbf{p}_{\text{min}}, \mathbf{p}_{\text{max}}] [ p min , p max ] FPS ( ⋅ , N ) \text{FPS}(\cdot, N) FPS ( ⋅ , N ) N N N N ∈ { 512 , 1024 } N \in \{512, 1024\} N ∈ { 512 , 1024 }
轻量级 DP3 编码器 (DP3 Point Encoder)
下采样后的稀疏点云P \mathbf{P} P v \mathbf{v} v
H = LayerNorm ( MLP 3 -Layer ( P ) ) ∈ R N × d hidden h global = MaxPool i = 1 N ( H i , : ) ∈ R d hidden v = ProjectionHead ( h global ) ∈ R d v \begin{aligned}
& \mathbf{H} = \text{LayerNorm}\left( \text{MLP}_{3\text{-Layer}}(\mathbf{P}) \right) \in \mathbb{R}^{N \times d_{\text{hidden}}} \\
& \mathbf{h}_{\text{global}} = \text{MaxPool}_{i=1}^N \left( \mathbf{H}_{i, :} \right) \in \mathbb{R}^{d_{\text{hidden}}} \\
& \mathbf{v} = \text{ProjectionHead}(\mathbf{h}_{\text{global}}) \in \mathbb{R}^{d_v}
\end{aligned} H = LayerNorm ( MLP 3 -Layer ( P ) ) ∈ R N × d hidden h global = MaxPool i = 1 N ( H i , : ) ∈ R d hidden v = ProjectionHead ( h global ) ∈ R d v
P ∈ R N × 3 \mathbf{P} \in \mathbb{R}^{N \times 3} P ∈ R N × 3 MLP 3 -Layer \text{MLP}_{3\text{-Layer}} MLP 3 -Layer MaxPool \text{MaxPool} MaxPool N N N v ∈ R d v \mathbf{v} \in \mathbb{R}^{d_v} v ∈ R d v d v = 64 d_v = 64 d v = 64
条件扩散动作生成与优化 (Conditional Action Generation)
去噪扩散生成推理 (DDIM Sampling / Inference)
决策模块构建为以 3D 视觉特征v \mathbf{v} v q \mathbf{q} q
推断阶段,从标准高斯噪声a K ∼ N ( 0 , I ) \mathbf{a}_K \sim \mathcal{N}(\mathbf{0}, \mathbf{I}) a K ∼ N ( 0 , I ) K K K K = 10 K=10 K = 10 a 0 \mathbf{a}_0 a 0
a k − 1 = α k ( a k − γ k ϵ θ ( a k , k , v , q ) ) + σ k z , z ∼ N ( 0 , I ) \mathbf{a}_{k-1} = \alpha_k \left( \mathbf{a}_k - \gamma_k \boldsymbol{\epsilon}_\theta(\mathbf{a}_k, k, \mathbf{v}, \mathbf{q}) \right) + \sigma_k \mathbf{z}, \quad \mathbf{z} \sim \mathcal{N}(\mathbf{0}, \mathbf{I}) a k − 1 = α k ( a k − γ k ϵ θ ( a k , k , v , q ) ) + σ k z , z ∼ N ( 0 , I )
a 0 ∈ R T a × D a \mathbf{a}_0 \in \mathbb{R}^{T_a \times D_a} a 0 ∈ R T a × D a T a T_a T a q ∈ R D q \mathbf{q} \in \mathbb{R}^{D_q} q ∈ R D q ϵ θ ( a k , k , v , q ) \boldsymbol{\epsilon}_\theta(\mathbf{a}_k, k, \mathbf{v}, \mathbf{q}) ϵ θ ( a k , k , v , q ) a k \mathbf{a}_k a k k k k v \mathbf{v} v q \mathbf{q} q α k , γ k , σ k \alpha_k, \gamma_k, \sigma_k α k , γ k , σ k k k k
训练目标与噪声预测 (Training Objective)
训练阶段,从专家演示数据集中随机采样无噪动作轨迹a 0 ∼ D \mathbf{a}_0 \sim \mathcal{D} a 0 ∼ D k ∈ { 1 , … , 100 } k \in \{1, \dots, 100\} k ∈ { 1 , … , 100 } ϵ k ∼ N ( 0 , I ) \boldsymbol{\epsilon}_k \sim \mathcal{N}(\mathbf{0}, \mathbf{I}) ϵ k ∼ N ( 0 , I )
网络采用样本预测/噪声重建均方误差 (MSE) 损失进行端到端优化:
a k = α ˉ k a 0 + β ˉ k ϵ k L DP3 ( θ ) = MSE ( ϵ k , ϵ θ ( a k , k , v , q ) ) = ∥ ϵ k − ϵ θ ( α ˉ k a 0 + β ˉ k ϵ k , k , v , q ) ∥ 2 2 \begin{aligned}
& \mathbf{a}_k = \bar{\alpha}_k \mathbf{a}_0 + \bar{\beta}_k \boldsymbol{\epsilon}_k \\
& \mathcal{L}_{\text{DP3}}(\theta) = \text{MSE}\left( \boldsymbol{\epsilon}_k, \, \boldsymbol{\epsilon}_\theta(\mathbf{a}_k, k, \mathbf{v}, \mathbf{q}) \right) = \left\| \boldsymbol{\epsilon}_k - \boldsymbol{\epsilon}_\theta\left( \bar{\alpha}_k \mathbf{a}_0 + \bar{\beta}_k \boldsymbol{\epsilon}_k, \, k, \, \mathbf{v}, \, \mathbf{q} \right) \right\|_2^2
\end{aligned} a k = α ˉ k a 0 + β ˉ k ϵ k L DP3 ( θ ) = MSE ( ϵ k , ϵ θ ( a k , k , v , q ) ) = ϵ k − ϵ θ ( α ˉ k a 0 + β ˉ k ϵ k , k , v , q ) 2 2
α ˉ k , β ˉ k \bar{\alpha}_k, \bar{\beta}_k α ˉ k , β ˉ k 训练超参数设置:训练时扩散步数设为 100,Batch Size 设为 128,训练 3000 个 Epoch 以确保收敛。
Flow Matching Action Expert (Pi0 and Pi0.7 as example)
π 0 \pi_0 π 0 π 0.7 \pi_{0.7} π 0.7
系统架构与端到端特征前向传播
系统由VLM 视觉-语言骨干网(VLM Backbone) 、MEM 历史视频编码器(History Vision Encoder) 以及动作专家网络(Action Expert) 三部分构成,遵循**知识隔离(Knowledge Insulation, KI)与 双专家混合(MoE-style Architecture)**设计。
多模态 Prompt 输入标记化
在时间步t t t C t \mathcal{C}_t C t
o t − T : t = [ I t − T : t 1 , … , I t − T : t n , q t − T : t ] , g t ⋆ = [ G t 1 , … , G t n ] C t = { ℓ t , ℓ ^ t , g t ⋆ , m t , c t } \begin{aligned} & \mathbf{o}_{t-T:t} = \left[ \mathbf{I}_{t-T:t}^1, \dots, \mathbf{I}_{t-T:t}^n, \mathbf{q}_{t-T:t} \right], \quad \mathbf{g}_t^\star = \left[ G_{t}^1, \dots, G_{t}^n \right] \\ & \mathcal{C}_t = \left\{ \ell_t, \, \hat{\ell}_t, \, \mathbf{g}_t^\star, \, m_t, \, c_t \right\} \end{aligned} o t − T : t = [ I t − T : t 1 , … , I t − T : t n , q t − T : t ] , g t ⋆ = [ G t 1 , … , G t n ] C t = { ℓ t , ℓ ^ t , g t ⋆ , m t , c t }
I t − T : t i ∈ R ( T + 1 ) × H × W × C \mathbf{I}_{t-T:t}^i \in \mathbb{R}^{(T+1) \times H \times W \times C} I t − T : t i ∈ R ( T + 1 ) × H × W × C i ∈ { 1 , … , n } i \in \{1, \dots, n\} i ∈ { 1 , … , n } T + 1 T+1 T + 1 448 × 448 448 \times 448 448 × 448
g t ⋆ \mathbf{g}_t^\star g t ⋆ g ψ g_\psi g ψ
ℓ t , ℓ ^ t \ell_t, \hat{\ell}_t ℓ t , ℓ ^ t "clean the kitchen")与当前局部子任务指令(如"open the fridge door")。
m t = { s t , q t , mistake t } m_t = \{s_t, q_t, \text{mistake}_t\} m t = { s t , q t , mistake t } s t s_t s t q t ∈ { 1 , … , 5 } q_t \in \{1,\dots,5\} q t ∈ { 1 , … , 5 } mistake t ∈ { true , false } \text{mistake}_t \in \{\text{true}, \text{false}\} mistake t ∈ { true , false }
c t ∈ { joint , ee } c_t \in \{\text{joint}, \text{ee}\} c t ∈ { joint , ee }
q t − T : t ∈ R ( T + 1 ) × D q \mathbf{q}_{t-T:t} \in \mathbb{R}^{(T+1) \times D_q} q t − T : t ∈ R ( T + 1 ) × D q
x state = W q q t − T : t ∈ R ( T + 1 ) × D VLM \mathbf{x}_{\text{state}} = \mathbf{W}_q \mathbf{q}_{t-T:t} \in \mathbb{R}^{(T+1) \times D_{\text{VLM}}} x state = W q q t − T : t ∈ R ( T + 1 ) × D VLM
骨干网注意力掩蔽与知识隔离 (Knowledge Insulation)
VLM 骨干网(π 0.7 \pi_{0.7} π 0.7 π 0 \pi_0 π 0
图像观测 Token 与子目标图像 Token 内部使用双向注意力,且子目标 Token 可注意力感知观测 Token;随后的文本与状态 Token 严格执行因果注意力。
动作专家网络(π 0.7 \pi_{0.7} π 0.7 π 0 \pi_0 π 0 H = 50 H=50 H = 50
知识隔离 (KI) :VLM 骨干网仅由 FAST 离散 Token 的交叉熵损失进行梯度更新;动作专家的流匹配梯度**严禁回传(No Gradient Flow)**至 VLM 骨干网,以保证视觉语言表征的稳健性。
基于条件流匹配的动作生成 (Conditional Flow Matching)
动作生成被表述为连续空间上的条件流匹配(CFM)过程,直接预测未来H = 50 H=50 H = 50 A t = a t : t + H − 1 ∈ R H × D a \mathbf{A}_t = \mathbf{a}_{t:t+H-1} \in \mathbb{R}^{H \times D_a} A t = a t : t + H − 1 ∈ R H × D a
概率路径与目标向量场
定义流匹配时间τ ∈ [ 0 , 1 ] \tau \in [0, 1] τ ∈ [ 0 , 1 ]
q ( A t τ ∣ A t ) = N ( τ A t , ( 1 − τ ) I ) q(\mathbf{A}_t^\tau \mid \mathbf{A}_t) = \mathcal{N}\left( \tau \mathbf{A}_t, \, (1 - \tau) \mathbf{I} \right) q ( A t τ ∣ A t ) = N ( τ A t , ( 1 − τ ) I )
采样标准高斯噪声ϵ ∼ N ( 0 , I ) \boldsymbol{\epsilon} \sim \mathcal{N}(\mathbf{0}, \mathbf{I}) ϵ ∼ N ( 0 , I )
A t τ = τ A t + ( 1 − τ ) ϵ \mathbf{A}_t^\tau = \tau \mathbf{A}_t + (1 - \tau) \boldsymbol{\epsilon} A t τ = τ A t + ( 1 − τ ) ϵ
该概率路径对应的目标去噪向量场为:
u ( A t τ ∣ A t ) = d d τ A t τ = A t − ϵ \mathbf{u}(\mathbf{A}_t^\tau \mid \mathbf{A}_t) = \frac{d}{d\tau} \mathbf{A}_t^\tau = \mathbf{A}_t - \boldsymbol{\epsilon} u ( A t τ ∣ A t ) = d τ d A t τ = A t − ϵ
训练优化目标
动作专家网络拟合条件向量场v θ ( A t τ , o t − T : t , C t , τ ) \mathbf{v}_\theta(\mathbf{A}_t^\tau, \mathbf{o}_{t-T:t}, \mathcal{C}_t, \tau) v θ ( A t τ , o t − T : t , C t , τ )
L CFM ( θ ) = E τ ∼ Beta ( a , b ) , ( o , A t ) ∼ D , ϵ ∼ N ( 0 , I ) [ ∥ v θ ( τ A t + ( 1 − τ ) ϵ , o t − T : t , C t , τ ) − ( A t − ϵ ) ∥ 2 2 ] \mathcal{L}_{\text{CFM}}(\theta) = \mathbb{E}_{\tau \sim \text{Beta}(a,b), \, (\mathbf{o}, \mathbf{A}_t) \sim \mathcal{D}, \, \boldsymbol{\epsilon} \sim \mathcal{N}(\mathbf{0}, \mathbf{I})} \left[ \left\Vert{} \mathbf{v}_\theta\left( \tau \mathbf{A}_t + (1 - \tau)\boldsymbol{\epsilon}, \, \mathbf{o}_{t-T:t}, \, \mathcal{C}_t, \, \tau \right) - (\mathbf{A}_t - \boldsymbol{\epsilon}) \right\Vert{}_2^2 \right] L CFM ( θ ) = E τ ∼ Beta ( a , b ) , ( o , A t ) ∼ D , ϵ ∼ N ( 0 , I ) [ ∥ v θ ( τ A t + ( 1 − τ ) ϵ , o t − T : t , C t , τ ) − ( A t − ϵ ) ∥ 2 2 ]
τ ∼ Beta ( a , b ) \tau \sim \text{Beta}(a, b) τ ∼ Beta ( a , b )
欧拉积分推断与无分类器引导 (CFG)
推断时,从纯高斯噪声A t 0 ∼ N ( 0 , I ) \mathbf{A}_t^0 \sim \mathcal{N}(\mathbf{0}, \mathbf{I}) A t 0 ∼ N ( 0 , I ) K K K δ = 1 / K \delta = 1/K δ = 1/ K
A t τ + δ = A t τ + δ ⋅ v ^ θ ( A t τ , o t − T : t , C t , τ ) \mathbf{A}_t^{\tau + \delta} = \mathbf{A}_t^\tau + \delta \cdot \hat{\mathbf{v}}_\theta(\mathbf{A}_t^\tau, \mathbf{o}_{t-T:t}, \mathcal{C}_t, \tau) A t τ + δ = A t τ + δ ⋅ v ^ θ ( A t τ , o t − T : t , C t , τ )
针对 Episode 元数据m t m_t m t
v ^ θ = v θ ( A t τ , o t − T : t , C t , τ ) + β ( v θ ( A t τ , o t − T : t , C t , τ ) − v θ ( A t τ , o t − T : t , C t uncond , τ ) ) \hat{\mathbf{v}}_\theta = \mathbf{v}_\theta(\mathbf{A}_t^\tau, \mathbf{o}_{t-T:t}, \mathcal{C}_t, \tau) + \beta \left( \mathbf{v}_\theta(\mathbf{A}_t^\tau, \mathbf{o}_{t-T:t}, \mathcal{C}_t, \tau) - \mathbf{v}_\theta(\mathbf{A}_t^\tau, \mathbf{o}_{t-T:t}, \mathcal{C}_t^{\text{uncond}}, \tau) \right) v ^ θ = v θ ( A t τ , o t − T : t , C t , τ ) + β ( v θ ( A t τ , o t − T : t , C t , τ ) − v θ ( A t τ , o t − T : t , C t uncond , τ ) )
C t uncond \mathcal{C}_t^{\text{uncond}} C t uncond m t m_t m t β ∈ [ 1.3 , 2.2 ] \beta \in [1.3, 2.2] β ∈ [ 1.3 , 2.2 ]
基于条件流匹配(Conditional Flow Matching, CFM)的动作生成详解
扩散模型(Diffusion) 就像是把一张照片加满噪点,然后一步步把噪点擦掉恢复照片。它的轨迹是随机游走弯弯曲曲的,需要去噪很多步(如 20~50 步),速度较慢。流匹配(Flow Matching) 不走弯路,而是直接在“随机噪声”和“真实动作”之间拉一条最平直的路线(直达矢量的场/速度场)。模型不需要一步步繁琐去噪,只需沿着这个“矢量场”推几步(如 5~10 步),就能极快地生成平滑连续的动作。C \mathcal{C} C 获取真值(Target):从数据集中取出真实机械臂未来 50 步的连续动作轨迹,记为A real \mathbf{A}_{\text{real}} A real
随机加噪(构建直达路径):
随机抽样一个纯高斯噪声轨迹ϵ ∼ N ( 0 , I ) \boldsymbol{\epsilon} \sim \mathcal{N}(\mathbf{0}, \mathbf{I}) ϵ ∼ N ( 0 , I ) τ = 0 \tau=0 τ = 0
随机选择一个时刻τ ∈ [ 0 , 1 ] \tau \in [0, 1] τ ∈ [ 0 , 1 ] τ = 0.4 \tau = 0.4 τ = 0.4
根据最平直的线性插值路径,合成出该时刻的“半成品带噪动作”:A τ = τ A real + ( 1 − τ ) ϵ \mathbf{A}^\tau = \tau \mathbf{A}_{\text{real}} + (1 - \tau) \boldsymbol{\epsilon} A τ = τ A real + ( 1 − τ ) ϵ
计算理想速度矢量(Ground Truth Field):从起点ϵ \boldsymbol{\epsilon} ϵ A real \mathbf{A}_{\text{real}} A real u = A real − ϵ \mathbf{u} = \mathbf{A}_{\text{real}} - \boldsymbol{\epsilon} u = A real − ϵ
网络预测与 Loss 计算:把“半成品动作”A τ \mathbf{A}^\tau A τ τ \tau τ C \mathcal{C} C v θ \mathbf{v}_\theta v θ v θ ( A τ , C , τ ) \mathbf{v}_\theta(\mathbf{A}^\tau, \mathcal{C}, \tau) v θ ( A τ , C , τ ) L = ∥ v θ − u ∥ 2 \mathcal{L} = \Vert{}\mathbf{v}_\theta - \mathbf{u}\Vert{}^2 L = ∥ v θ − u ∥ 2
起点(τ = 0 \tau = 0 τ = 0 A 0 ∼ N ( 0 , I ) \mathbf{A}^0 \sim \mathcal{N}(\mathbf{0}, \mathbf{I}) A 0 ∼ N ( 0 , I )
多步欧拉积分去噪(例如K = 5 K=5 K = 5 δ = 0.2 \delta = 0.2 δ = 0.2 τ = 0.0 \tau = 0.0 τ = 0.0 A 0 \mathbf{A}^0 A 0 C \mathcal{C} C v 0 \mathbf{v}_0 v 0 A 0.2 = A 0 + 0.2 × v 0 \mathbf{A}^{0.2} = \mathbf{A}^0 + 0.2 \times \mathbf{v}_0 A 0.2 = A 0 + 0.2 × v 0 τ = 0.2 \tau = 0.2 τ = 0.2 A 0.2 \mathbf{A}^{0.2} A 0.2 v 0.2 \mathbf{v}_{0.2} v 0.2 A 0.4 = A 0.2 + 0.2 × v 0.2 \mathbf{A}^{0.4} = \mathbf{A}^{0.2} + 0.2 \times \mathbf{v}_{0.2} A 0.4 = A 0.2 + 0.2 × v 0.2 τ = 1.0 \tau = 1.0 τ = 1.0
终点(τ = 1.0 \tau = 1.0 τ = 1.0 A 1.0 \mathbf{A}^{1.0} A 1.0
下发执行:将这 50 步动作的前 15~25 步直接下发给底层的机械臂电机控制器(PD / IK)去执行,同时异步启动下一次流匹配推理。
多模态 Prompt 扩充与 Dropout 训练策略
为了利用次优轨迹、失败样例与异构跨具身数据,π 0.7 \pi_{0.7} π 0.7
子目标图像g t ⋆ \mathbf{g}_t^\star g t ⋆ :仅在 25% 的训练样本中保留。保留样本中,75% 采样未来0 ∼ 4 0 \sim 4 0 ∼ 4 g ψ g_\psi g ψ ℓ ^ t \hat{\ell}_t ℓ ^ t Episode 元数据m t m_t m t :15% 的概率整体丢弃;保留时,内部各字段(Speed, Quality, Mistake)各有 5% 的独立丢弃概率。历史帧与视角 :历史图像与状态整体有 30% 概率丢弃;后视摄像头有 30% 概率独立丢弃。
实时动作块控制与测试期部署算法 (RTC Deployment)
测试部署时,结合实时动作块(Real-Time Action Chunking, RTC)机制与多线程异步推断,消除推理延迟带来的机械臂卡顿。
测试期部署逻辑说明
初始化 :传入初始观测o 0 \mathbf{o}_0 o 0 ℓ \ell ℓ m m m c c c ℓ ^ \hat{\ell} ℓ ^ 异步线程 1(子目标生成) :当子任务ℓ ^ \hat{\ell} ℓ ^ Δ = 4 \Delta = 4 Δ = 4 g ⋆ ∼ p ψ ( g ⋆ ∣ o t , ℓ ^ , m ) \mathbf{g}^\star \sim p_\psi(\mathbf{g}^\star \mid \mathbf{o}_t, \hat{\ell}, m) g ⋆ ∼ p ψ ( g ⋆ ∣ o t , ℓ ^ , m ) C \mathcal{C} C 主控制线程(动作专家推断) :若距离上次推断已执行H ^ \hat{H} H ^ H ^ ∈ [ 15 , 25 ] \hat{H} \in [15, 25] H ^ ∈ [ 15 , 25 ] A t ∼ π θ ( A ∣ o t − T : t , C , a t : ) \mathbf{A}_t \sim \pi_\theta(\mathbf{A} \mid \mathbf{o}_{t-T:t}, \mathcal{C}, \mathbf{a}_{t:}) A t ∼ π θ ( A ∣ o t − T : t , C , a t : ) 0 ∼ 240 ms 0 \sim 240\text{ms} 0 ∼ 240 ms 底层执行 :下发当前步物理动作a t \mathbf{a}_t a t
统一或混合式动作生成
RDT2:探索UMI数据在零样本跨具身泛化中的扩展极限
RDT2 旨在解决大规模多模态动作分布建模与超大型 VLA 模型实时部署的冲突。系统通过硬件升级采集大规模 UMI(Universal Manipulation Interface)双手数据,并引入三阶段混合训练架构(离散预训练→ \to → → \to →
硬件迭代与数据规模 (Hardware & Dataset Scaling)
采用重新设计的手持 UMI 硬件,通过 CNC 尼龙66/玻璃纤维加工提升机械刚度,引入红外光六维姿态跟踪解决无纹理/高速运动场景漂移,并优化平行颌夹爪结构。
在自然环境中录制超过 10,000 小时、涵盖 100+ 家庭的双手 6 自由度末端姿态与夹爪动作数据集D \mathcal{D} D
D : = { ( ℓ ( i ) , o t ( i ) , A t ( i ) ) | 0 ≤ t < T ( i ) , 1 ≤ i ≤ N } \mathcal{D} := \left\{ \left( \ell^{(i)}, \, \mathbf{o}_t^{(i)}, \, \mathbf{A}_t^{(i)} \right) \;\middle|\; 0 \le t < T^{(i)}, \, 1 \le i \le N \right\} D := { ( ℓ ( i ) , o t ( i ) , A t ( i ) ) 0 ≤ t < T ( i ) , 1 ≤ i ≤ N }
ℓ ( i ) \ell^{(i)} ℓ ( i ) i i i o t ( i ) ∈ R H × W × C \mathbf{o}_t^{(i)} \in \mathbb{R}^{H \times W \times C} o t ( i ) ∈ R H × W × C t t t A t ( i ) = [ a t ( i ) , a t + 1 ( i ) , … , a t + T a ( i ) ] ⊤ ∈ R T a × d \mathbf{A}_t^{(i)} = [\mathbf{a}_t^{(i)}, \mathbf{a}_{t+1}^{(i)}, \dots, \mathbf{a}_{t+T_a}^{(i)}]^\top \in \mathbb{R}^{T_a \times d} A t ( i ) = [ a t ( i ) , a t + 1 ( i ) , … , a t + T a ( i ) ] ⊤ ∈ R T a × d d d d T a T_a T a N N N N > 10 , 000 N > 10,000 N > 10 , 000
第一阶段:残差矢量量化与离散 VLM 预训练 (Stage 1: RVQ & Discrete VLM Pre-training)
为了保留预训练 VLM 的语言推理与离散概率知识,并加速收敛,第一阶段通过残差矢量量化(RVQ)将连续动作块离散化,使用交叉熵目标对 VLM 骨干网进行预训练。
RVQ 动作分词器 (RVQ Action Tokenizer)
采用一维时间卷积神经网络编码器ϕ enc \phi_{\text{enc}} ϕ enc M M M ϕ dec \phi_{\text{dec}} ϕ dec
{ z i } i = 1 n = ϕ enc ( A t ) , z i ∈ R C \{\mathbf{z}_i\}_{i=1}^n = \phi_{\text{enc}}(\mathbf{A}_t), \quad \mathbf{z}_i \in \mathbb{R}^C { z i } i = 1 n = ϕ enc ( A t ) , z i ∈ R C 对每个潜在向量z i \mathbf{z}_i z i r 0 i = z i \mathbf{r}_0^i = \mathbf{z}_i r 0 i = z i j = 1 , … , M j = 1, \dots, M j = 1 , … , M
k j i = arg min 1 ≤ k ≤ K ∥ r j − 1 i − e j ( k ) ∥ 2 2 r j i = r j − 1 i − e j ( k j i ) \begin{aligned}
k_j^i &= \arg\min_{1 \le k \le K} \left\| \mathbf{r}_{j-1}^i - \mathbf{e}_j(k) \right\|_2^2 \\
\mathbf{r}_j^i &= \mathbf{r}_{j-1}^i - \mathbf{e}_j(k_j^i)
\end{aligned} k j i r j i = arg 1 ≤ k ≤ K min r j − 1 i − e j ( k ) 2 2 = r j − 1 i − e j ( k j i ) 解码重构动作块A ^ t \hat{\mathbf{A}}_t A ^ t L vq \mathcal{L}_{\text{vq}} L vq
A ^ t = ϕ dec ( { z ^ i } i = 1 n ) = ϕ dec ( { ∑ j = 1 M e j ( k j i ) } i = 1 n ) \hat{\mathbf{A}}_t = \phi_{\text{dec}}\left( \left\{ \hat{\mathbf{z}}_i \right\}_{i=1}^n \right) = \phi_{\text{dec}}\left( \left\{ \sum_{j=1}^M \mathbf{e}_j(k_j^i) \right\}_{i=1}^n \right) A ^ t = ϕ dec ( { z ^ i } i = 1 n ) = ϕ dec { j = 1 ∑ M e j ( k j i ) } i = 1 n L vq = E ( ⋅ , ⋅ , A t ) ∼ D [ ∥ A t − A ^ t ∥ 2 2 + ∥ sg ( z i ) − z ^ i ∥ 2 2 + β ∥ z i − sg ( z ^ i ) ∥ 2 2 ] \mathcal{L}_{\text{vq}} = \mathbb{E}_{(\cdot, \cdot, \mathbf{A}_t) \sim \mathcal{D}} \left[ \|\mathbf{A}_t - \hat{\mathbf{A}}_t\|_2^2 + \|\text{sg}(\mathbf{z}_i) - \hat{\mathbf{z}}_i\|_2^2 + \beta \|\mathbf{z}_i - \text{sg}(\hat{\mathbf{z}}_i)\|_2^2 \right] L vq = E ( ⋅ , ⋅ , A t ) ∼ D [ ∥ A t − A ^ t ∥ 2 2 + ∥ sg ( z i ) − z ^ i ∥ 2 2 + β ∥ z i − sg ( z ^ i ) ∥ 2 2 ]
e j ∈ R K × C \mathbf{e}_j \in \mathbb{R}^{K \times C} e j ∈ R K × C j j j K K K { k 1 i , … , k M i } i = 1 n \{k_1^i, \dots, k_M^i\}_{i=1}^n { k 1 i , … , k M i } i = 1 n A t \mathbf{A}_t A t n × M n \times M n × M sg ( ⋅ ) \text{sg}(\cdot) sg ( ⋅ )
VLM 骨干网交叉熵预训练
基于 Qwen2.5-VL (7B) 骨干网,覆盖词表末尾使用频率最低的 1024 个标记用于映射动作 Token。采用标准自回归下一个 Token 预测(Next-Token Prediction)目标训练 128k 次迭代:
L Stage1 ( Θ VLM ) = − ∑ i = 1 n ∑ j = 1 M log P Θ VLM ( k j i | k < j i , k < i , ℓ , o t ) \mathcal{L}_{\text{Stage1}}(\Theta_{\text{VLM}}) = -\sum_{i=1}^n \sum_{j=1}^M \log P_{\Theta_{\text{VLM}}}\left( k_j^i \;\middle|\; k_{<j}^i, k_{<i}, \ell, \mathbf{o}_t \right) L Stage1 ( Θ VLM ) = − i = 1 ∑ n j = 1 ∑ M log P Θ VLM ( k j i k < j i , k < i , ℓ , o t )
Θ VLM \Theta_{\text{VLM}} Θ VLM
第二阶段:连续流匹配动作专家训练 (Stage 2: Flow Matching Action Expert)
为了消除自回归生成的量化误差与低效性,第二阶段冻结已预训练的 VLM 骨干网 ,训练一个 400M 参数的连续动作专家(RDT-1B 变体,引入 GQA 优化速度)。动作专家通过交叉注意力(Cross-Attention)融合 VLM 各层的潜在特征。
连续流匹配训练目标 (Flow Matching Loss)
采样流匹配时间步τ ∼ U ( 0 , 1 ) \tau \sim \mathcal{U}(0, 1) τ ∼ U ( 0 , 1 ) ϵ ∼ N ( 0 , I ) \boldsymbol{\epsilon} \sim \mathcal{N}(\mathbf{0}, \mathbf{I}) ϵ ∼ N ( 0 , I ) A t τ \mathbf{A}_t^\tau A t τ u \mathbf{u} u
A t τ = ( 1 − τ ) ϵ + τ A t , u ( A t τ ∣ A t ) = A t − ϵ \mathbf{A}_t^\tau = (1 - \tau)\boldsymbol{\epsilon} + \tau \mathbf{A}_t, \quad \mathbf{u}(\mathbf{A}_t^\tau \mid \mathbf{A}_t) = \mathbf{A}_t - \boldsymbol{\epsilon} A t τ = ( 1 − τ ) ϵ + τ A t , u ( A t τ ∣ A t ) = A t − ϵ 动作专家去噪网络v θ \mathbf{v}_\theta v θ
L expert ( θ ) = E ( ℓ , o t , A t ) ∼ D , τ ∼ U ( 0 , 1 ) , ϵ ∼ N ( 0 , I ) [ ∥ v θ ( τ , A t τ , VLA frozen ( ℓ , o t ) ) − ( A t − ϵ ) ∥ 2 2 ] \mathcal{L}_{\text{expert}}(\theta) = \mathbb{E}_{(\ell, \mathbf{o}_t, \mathbf{A}_t) \sim \mathcal{D}, \, \tau \sim \mathcal{U}(0, 1), \, \boldsymbol{\epsilon} \sim \mathcal{N}(\mathbf{0}, \mathbf{I})} \left[ \left\| \mathbf{v}_\theta\left( \tau, \mathbf{A}_t^\tau, \text{VLA}_{\text{frozen}}(\ell, \mathbf{o}_t) \right) - (\mathbf{A}_t - \boldsymbol{\epsilon}) \right\|_2^2 \right] L expert ( θ ) = E ( ℓ , o t , A t ) ∼ D , τ ∼ U ( 0 , 1 ) , ϵ ∼ N ( 0 , I ) [ ∥ v θ ( τ , A t τ , VLA frozen ( ℓ , o t ) ) − ( A t − ϵ ) ∥ 2 2 ]
θ \theta θ VLA frozen ( ℓ , o t ) \text{VLA}_{\text{frozen}}(\ell, \mathbf{o}_t) VLA frozen ( ℓ , o t )
采样推断 (Multi-step Euler Inference)
从纯高斯噪声A t 0 ∼ N ( 0 , I ) \mathbf{A}_t^0 \sim \mathcal{N}(\mathbf{0}, \mathbf{I}) A t 0 ∼ N ( 0 , I ) δ τ = 0.2 \delta\tau = 0.2 δ τ = 0.2
A t τ + δ τ = A t τ + δ τ ⋅ v θ ( τ , A t τ , VLA frozen ( ℓ , o t ) ) , τ ∈ { 0 , 0.2 , 0.4 , 0.6 , 0.8 } \mathbf{A}_t^{\tau + \delta\tau} = \mathbf{A}_t^\tau + \delta\tau \cdot \mathbf{v}_\theta\left( \tau, \mathbf{A}_t^\tau, \text{VLA}_{\text{frozen}}(\ell, \mathbf{o}_t) \right), \quad \tau \in \{0, 0.2, 0.4, 0.6, 0.8\} A t τ + δ τ = A t τ + δ τ ⋅ v θ ( τ , A t τ , VLA frozen ( ℓ , o t ) ) , τ ∈ { 0 , 0.2 , 0.4 , 0.6 , 0.8 } 第三阶段:单步生成器扩散蒸馏 (Stage 3: Diffusion Distillation for Fast Inference)
为满足高动态任务(如打乒乓球)的极低延迟需求,第三阶段通过在线扩散蒸馏,将第二阶段的多步动作专家v θ \mathbf{v}_\theta v θ G θ ′ \mathcal{G}_{\theta'} G θ ′
单步回归目标 (On-the-fly Regression Loss)
初始化可训练参数θ ′ ← θ \theta' \leftarrow \theta θ ′ ← θ v θ \mathbf{v}_\theta v θ F \mathcal{F} F
F ( A t 0 , ℓ , o t ; θ ) = A t τ = 1 ( 来自第二阶段教师模型的 5 步积分结果 ) G ( A t 0 , ℓ , o t ; θ ′ ) = A t 0 + v θ ′ ( 0 , A t 0 , VLA frozen ( ℓ , o t ) ) \begin{aligned}
& \mathcal{F}(\mathbf{A}_t^0, \ell, \mathbf{o}_t; \theta) = \mathbf{A}_t^{\tau=1} \quad (\text{来自第二阶段教师模型的 5 步积分结果}) \\
& \mathcal{G}(\mathbf{A}_t^0, \ell, \mathbf{o}_t; \theta') = \mathbf{A}_t^0 + \mathbf{v}_{\theta'}\left( 0, \mathbf{A}_t^0, \text{VLA}_{\text{frozen}}(\ell, \mathbf{o}_t) \right)
\end{aligned} F ( A t 0 , ℓ , o t ; θ ) = A t τ = 1 ( 来自第二阶段教师模型的 5 步积分结果 ) G ( A t 0 , ℓ , o t ; θ ′ ) = A t 0 + v θ ′ ( 0 , A t 0 , VLA frozen ( ℓ , o t ) ) 损失函数定义为单步预测与教师 5 步结果的 MSE 回归:
L distill ( θ ′ ) = E ( ℓ , o t ) ∼ D , A t 0 ∼ N ( 0 , I ) [ ∥ F ( A t 0 , ℓ , o t ; θ ) − G ( A t 0 , ℓ , o t ; θ ′ ) ∥ 2 2 ] \mathcal{L}_{\text{distill}}(\theta') = \mathbb{E}_{(\ell, \mathbf{o}_t) \sim \mathcal{D}, \, \mathbf{A}_t^0 \sim \mathcal{N}(\mathbf{0}, \mathbf{I})} \left[ \left\| \mathcal{F}(\mathbf{A}_t^0, \ell, \mathbf{o}_t; \theta) - \mathcal{G}(\mathbf{A}_t^0, \ell, \mathbf{o}_t; \theta') \right\|_2^2 \right] L distill ( θ ′ ) = E ( ℓ , o t ) ∼ D , A t 0 ∼ N ( 0 , I ) [ F ( A t 0 , ℓ , o t ; θ ) − G ( A t 0 , ℓ , o t ; θ ′ ) 2 2 ] 极速推断 (Single-Step Inference)
部署时仅需一次前向传播即可直接生成最终连续动作块:
A t final = A t 0 + v θ ′ ( 0 , A t 0 , VLA frozen ( ℓ , o t ) ) , A t 0 ∼ N ( 0 , I ) \mathbf{A}_t^{\text{final}} = \mathbf{A}_t^0 + \mathbf{v}_{\theta'}\left( 0, \mathbf{A}_t^0, \text{VLA}_{\text{frozen}}(\ell, \mathbf{o}_t) \right), \quad \mathbf{A}_t^0 \sim \mathcal{N}(\mathbf{0}, \mathbf{I}) A t final = A t 0 + v θ ′ ( 0 , A t 0 , VLA frozen ( ℓ , o t ) ) , A t 0 ∼ N ( 0 , I ) 离散扩散 VLA:将离散扩散引入 视觉-语言-行动策略中的动作解码
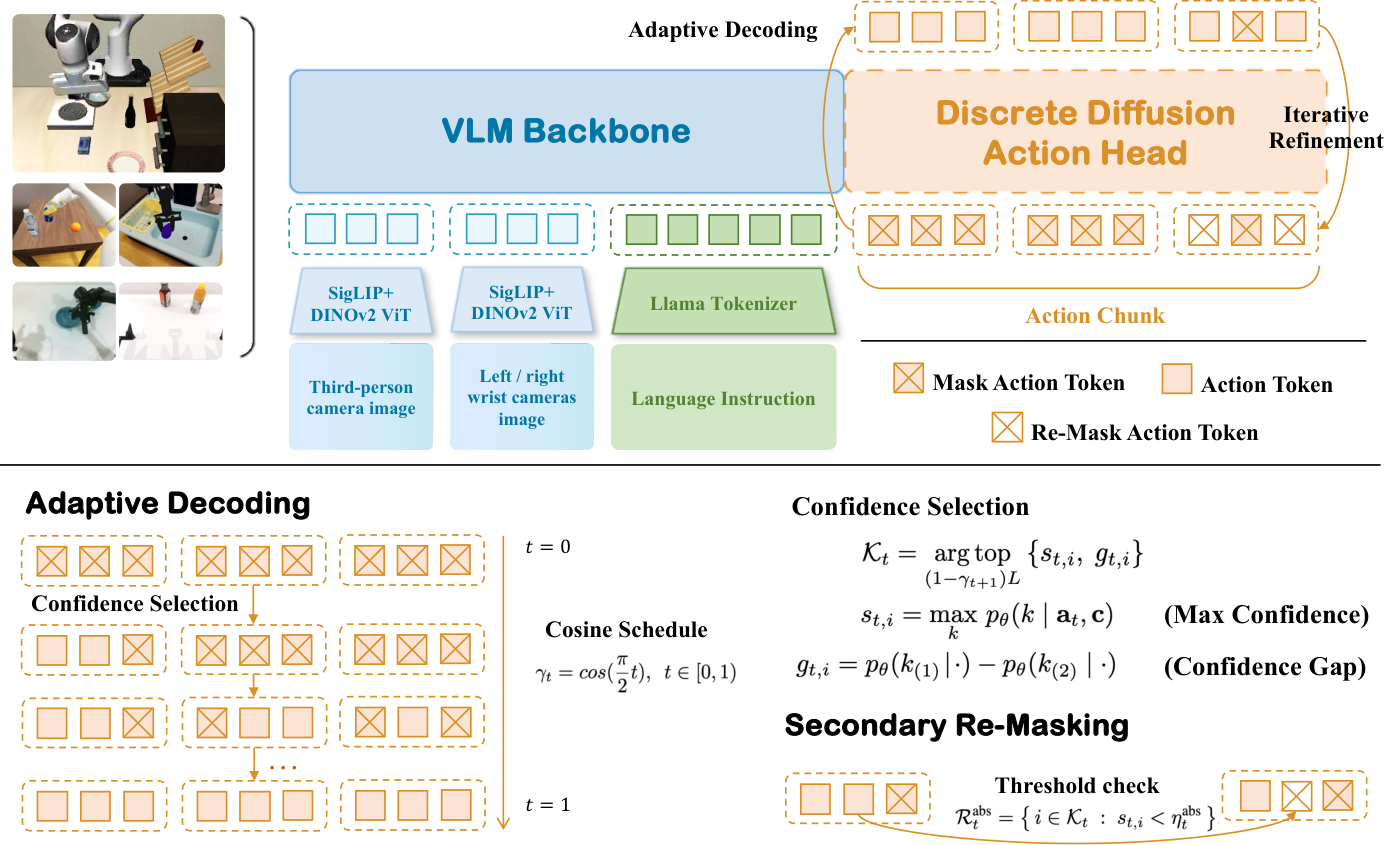
离散扩散 VLA(Discrete Diffusion VLA)旨在解决传统自回归 VLA 模型(如 OpenVLA)逐标记预测导致的高延迟问题,同时消除单独引入连续扩散网络时与 VLM 交叉熵损失产生的梯度竞争。
该架构将感知、指令理解与动作去噪统一于单一 Transformer 主干网络中,将动作生成表述为在离散词表上的掩码扩散(Masked Diffusion)过程,支持测试期的高效动作块并行解码与自适应二次重掩蔽(Secondary Remasking)。
动作离散化与词表扩充 (Action Discretization & Vocabulary Augmentation)
输入动作采用基于分位数的离散化方案,将连续动作块映射为离散标记序列,并扩充特殊掩码标记[MASK]。
a 0 = ( a 0 , 1 , a 0 , 2 , … , a 0 , L ) , a 0 , i ∈ { 1 , 2 , … , K } L = H × D action , D action = 7 , K = 256 V action = { 1 , 2 , … , K } ∪ { [MASK] } , ∣ V action ∣ = V = K + 1 \begin{aligned} & \mathbf{a}_0 = (a_{0, 1}, a_{0, 2}, \dots, a_{0, L}), \quad a_{0, i} \in \{1, 2, \dots, K\} \\ & L = H \times D_{\text{action}}, \quad D_{\text{action}} = 7, \quad K = 256 \\ & \mathcal{V}_{\text{action}} = \{1, 2, \dots, K\} \cup \{\text{[MASK]}\}, \quad \vert{}\mathcal{V}_{\text{action}}\vert{} = V = K + 1 \end{aligned} a 0 = ( a 0 , 1 , a 0 , 2 , … , a 0 , L ) , a 0 , i ∈ { 1 , 2 , … , K } L = H × D action , D action = 7 , K = 256 V action = { 1 , 2 , … , K } ∪ { [MASK] } , ∣ V action ∣ = V = K + 1
H H H D action D_{\text{action}} D action L L L K K K a 0 \mathbf{a}_0 a 0 e a 0 , i ∈ R V \mathbf{e}_{a_{0, i}} \in \mathbb{R}^V e a 0 , i ∈ R V
动作离散化与词表扩充:把物理动作变成“填字游戏” 0.0123 m 0.0123\text{m} 0.0123 m
机械臂的单步动作(D action = 7 D_{\text{action}} = 7 D action = 7 Δ x , Δ y , Δ z \Delta x, \Delta y, \Delta z Δ x , Δ y , Δ z Δ roll , Δ pitch , Δ yaw \Delta \text{roll}, \Delta \text{pitch}, \Delta \text{yaw} Δ roll , Δ pitch , Δ yaw
动作块(Action Chunk,H H H H = 10 H = 10 H = 10
动作序列总长度L L L L = H × D action L = H \times D_{\text{action}} L = H × D action H = 10 H=10 H = 10 10 × 7 = 70 10 \times 7 = 70 10 × 7 = 70 L L L L = 70 L=70 L = 70 i i i i i i i = 1 i=1 i = 1 x x x i = 7 i=7 i = 7 i = 8 i=8 i = 8 x x x
{ 1 , … , K } \{1, \dots, K\} { 1 , … , K }
{ 1 , … , K } \{1, \dots, K\} { 1 , … , K } K = 256 K=256 K = 256 0.0123456 … m 0.0123456\dots\text{m} 0.0123456 … m 1 ∼ 256 1 \sim 256 1 ∼ 256 { 1 , … , K } \{1, \dots, K\} { 1 , … , K } [MASK] 遮罩标记:这是一个特殊符号,代表“还没想好 / 空白”。
扩充词表V = { 1 , … , K } ∪ { [MASK] } \mathcal{V} = \{1, \dots, K\} \cup \{\text{[MASK]}\} V = { 1 , … , K } ∪ { [MASK] } L L L L L L { 1 , … , K } \{1, \dots, K\} { 1 , … , K } 1 ∼ 256 1 \sim 256 1 ∼ 256 { 1 , … , K } \{1,\dots,K\} { 1 , … , K }
离散扩散马尔可夫前向过程 (Discrete Diffusion Forward Noise Process)
前向加噪过程定义为离散马尔可夫链{ a t } t = 0 T \{ \mathbf{a}_t \}_{t=0}^T { a t } t = 0 T β t \beta_t β t [MASK](记为e M \mathbf{e}_M e M 1 − β t 1 - \beta_t 1 − β t
单步转移矩阵Q t ∈ R V × V \mathbf{Q}_t \in \mathbb{R}^{V \times V} Q t ∈ R V × V t t t q ( a t ∣ a 0 ) q(\mathbf{a}_t \mid \mathbf{a}_0) q ( a t ∣ a 0 )
Q t e a t , i = ( 1 − β t ) e a t , i + β t e M Q ˉ t = Q t Q t − 1 ⋯ Q 1 q ( a t ∣ a 0 ) = ∏ i = 1 L Categorical ( a t , i | Q ˉ t e a 0 , i ) \begin{aligned} & \mathbf{Q}_t \mathbf{e}_{a_{t, i}} = (1 - \beta_t) \mathbf{e}_{a_{t, i}} + \beta_t \mathbf{e}_M \\ & \bar{\mathbf{Q}}_t = \mathbf{Q}_t \mathbf{Q}_{t-1} \cdots \mathbf{Q}_1 \\ & q(\mathbf{a}_t \mid \mathbf{a}_0) = \prod_{i=1}^L \text{Categorical}\left( a_{t, i} \;\middle\vert{}\; \bar{\mathbf{Q}}_t \mathbf{e}_{a_{0, i}} \right) \end{aligned} Q t e a t , i = ( 1 − β t ) e a t , i + β t e M Q ˉ t = Q t Q t − 1 ⋯ Q 1 q ( a t ∣ a 0 ) = i = 1 ∏ L Categorical ( a t , i Q ˉ t e a 0 , i )
β t ∈ ( 0 , 1 ) \beta_t \in (0, 1) β t ∈ ( 0 , 1 ) t t t γ t ∈ ( 0 , 1 ] \gamma_t \in (0, 1] γ t ∈ ( 0 , 1 ] t t t [MASK] 的标记比例。a ~ t \tilde{\mathbf{a}}_t a ~ t γ t \gamma_t γ t [MASK] 后获得的损坏动作序列。
离散扩散马尔可夫前向过程:通俗理解与核心目的 q ( a t ∣ a 0 ) q(\mathbf{a}_t \mid \mathbf{a}_0) q ( a t ∣ a 0 ) t t t γ t \gamma_t γ t
基于 Prismatic-7B / Llama 2 VLM 骨干网络,多模态特征输入与注意力掩蔽规则如下:
c = [ X vis , X lang , X prop ] X vis = Projector ( [ SigLIP ( I head ) , DINOv2 ( I head ) , WristViews ] ) X prop = MLP ( q arm ) Z in = [ c ∥ a ~ t ] p θ ( ⋅ ∣ a ~ t , c ) = Softmax ( W head ⋅ f θ ( Z in ) ) \begin{aligned} & \mathbf{c} = \left[ \mathbf{X}_{\text{vis}}, \, \mathbf{X}_{\text{lang}}, \, \mathbf{X}_{\text{prop}} \right] \\ & \mathbf{X}_{\text{vis}} = \text{Projector}\left( \left[ \text{SigLIP}(I_{\text{head}}), \, \text{DINOv2}(I_{\text{head}}), \, \text{WristViews} \right] \right) \\ & \mathbf{X}_{\text{prop}} = \text{MLP}(\mathbf{q}_{\text{arm}}) \\ & \mathbf{Z}_{\text{in}} = \left[ \mathbf{c} \,\Vert{}\, \tilde{\mathbf{a}}_t \right] \\ & p_\theta(\cdot \mid \tilde{\mathbf{a}}_t, \mathbf{c}) = \text{Softmax}\left( \mathbf{W}_{\text{head}} \cdot f_\theta(\mathbf{Z}_{\text{in}}) \right) \end{aligned} c = [ X vis , X lang , X prop ] X vis = Projector ( [ SigLIP ( I head ) , DINOv2 ( I head ) , WristViews ] ) X prop = MLP ( q arm ) Z in = [ c ∥ a ~ t ] p θ ( ⋅ ∣ a ~ t , c ) = Softmax ( W head ⋅ f θ ( Z in ) )
c \mathbf{c} c X vis \mathbf{X}_{\text{vis}} X vis X lang \mathbf{X}_{\text{lang}} X lang X prop \mathbf{X}_{\text{prop}} X prop a ~ t \tilde{\mathbf{a}}_t a ~ t 全模态融合注意力 :取消动作标记上的因果掩蔽,对动作标记采用全双向注意力(Full Bidirectional Attention) ,使其可以同时感知所有视觉、语言、本体特征及其他动作标记。W head ∈ R K × D hidden \mathbf{W}_{\text{head}} \in \mathbb{R}^{K \times D_{\text{hidden}}} W head ∈ R K × D hidden
统一多模态骨干网架构的变量与符号拆解
Z in = [ c ∥ a ~ t ] \mathbf{Z}_{\text{in}} = \left[ \mathbf{c} \,\Vert{}\, \tilde{\mathbf{a}}_t \right] Z in = [ c ∥ a ~ t ]
c \mathbf{c} c a ~ t \tilde{\mathbf{a}}_t a ~ t L L L Z in \mathbf{Z}_{\text{in}} Z in
f θ ( Z in ) f_\theta(\mathbf{Z}_{\text{in}}) f θ ( Z in )
f θ f_\theta f θ θ \theta θ 输出结果是每个 Token 对应的高维隐层特征向量(Hidden States)。
W head \mathbf{W}_{\text{head}} W head
这是一个线性投影矩阵(Linear Projection Layer),维度为K × D hidden K \times D_{\text{hidden}} K × D hidden K = 256 K = 256 K = 256 D hidden D_{\text{hidden}} D hidden
它的作用是将动作位置输出的高维抽象特征映射到 256 个档位的原始 Logits 上。
Softmax ( ⋅ ) \text{Softmax}(\cdot) Softmax ( ⋅ ) 1 1 1 p θ ( ⋅ ∣ a ~ t , c ) p_\theta(\cdot \mid \tilde{\mathbf{a}}_t, \mathbf{c}) p θ ( ⋅ ∣ a ~ t , c ) c \mathbf{c} c a ~ t \tilde{\mathbf{a}}_t a ~ t
离散扩散训练目标 (Discrete Diffusion Training Objective)
训练时采样扩散时间时刻的掩码比例γ t ∼ CosineSchedule \gamma_t \sim \text{CosineSchedule} γ t ∼ CosineSchedule
L CE ( θ ) = − ∑ i ∈ M γ t log p θ ( a 0 , i | a ~ t , c ) \mathcal{L}_{\text{CE}}(\theta) = - \sum_{i \in \mathcal{M}_{\gamma_t}} \log p_\theta\left( a_{0, i} \;\middle\vert{}\; \tilde{\mathbf{a}}_t, \mathbf{c} \right) L CE ( θ ) = − i ∈ M γ t ∑ log p θ ( a 0 , i ∣ a ~ t , c )
M γ t \mathcal{M}_{\gamma_t} M γ t γ t \gamma_t γ t γ t × L \gamma_t \times L γ t × L 单次前向传播同时并行预测所有L L L
推理流水线:自适应解码与二次重掩蔽 (Adaptive Inference & Secondary Remasking)
推理阶段从全掩码序列a T = [ MASK ] L \mathbf{a}_T = [\text{MASK}]^L a T = [ MASK ] L γ 1 = 1 \gamma_1 = 1 γ 1 = 1 T T T
在每个时间步t t t γ t \gamma_t γ t γ t + 1 \gamma_{t+1} γ t + 1
贝叶斯反向去噪核 (Bayesian Reverse Step)
对每个位置i ∈ { 1 , … , L } i \in \{1, \dots, L\} i ∈ { 1 , … , L }
p θ ( a t − 1 , i ∣ a t , i , c ) = { δ ( a t − 1 , i = a t , i ) , a t , i ≠ [MASK] Categorical ( a t − 1 , i | π θ ( i ∣ c ) ) , a t , i = [MASK] p_\theta(a_{t-1, i} \mid a_{t, i}, \mathbf{c}) = \begin{cases} \delta(a_{t-1, i} = a_{t, i}), & a_{t, i} \neq \text{[MASK]} \\ \text{Categorical}\left( a_{t-1, i} \;\middle\vert{}\; \pi_\theta(i \mid \mathbf{c}) \right), & a_{t, i} = \text{[MASK]} \end{cases} p θ ( a t − 1 , i ∣ a t , i , c ) = { δ ( a t − 1 , i = a t , i ) , Categorical ( a t − 1 , i ∣ π θ ( i ∣ c ) ) , a t , i = [MASK] a t , i = [MASK]
设置两种自适应置信度评估指标之一:
最大置信度: s t , i = max k p θ ( k ∣ a t , c ) 置信度间隙: g t , i = p θ ( k ( 1 ) ∣ a t , c ) − p θ ( k ( 2 ) ∣ a t , c ) \begin{aligned} & \text{最大置信度: } s_{t, i} = \max_k p_\theta(k \mid \mathbf{a}_t, \mathbf{c}) \\ & \text{置信度间隙: } g_{t, i} = p_\theta(k^{(1)} \mid \mathbf{a}_t, \mathbf{c}) - p_\theta(k^{(2)} \mid \mathbf{a}_t, \mathbf{c}) \end{aligned} 最大置信度 : s t , i = k max p θ ( k ∣ a t , c ) 置信度间隙 : g t , i = p θ ( k ( 1 ) ∣ a t , c ) − p θ ( k ( 2 ) ∣ a t , c )
k ( 1 ) , k ( 2 ) k^{(1)}, k^{(2)} k ( 1 ) , k ( 2 )
提交选择与 Gumbel 采样 (Commitment & Gumbel Sampling)
选取置信度评分最高的前( 1 − γ t + 1 ) L (1 - \gamma_{t+1}) L ( 1 − γ t + 1 ) L K t \mathcal{K}_t K t
a t + 1 , i ∈ K t ∼ Categorical ( Softmax ( log p θ ( ⋅ ∣ a t , c ) + ε τ t ) ) a_{t+1, i} \in \mathcal{K}_t \sim \text{Categorical}\left( \text{Softmax}\left( \frac{\log p_\theta(\cdot \mid \mathbf{a}_t, \mathbf{c}) + \boldsymbol{\varepsilon}}{\tau_t} \right) \right) a t + 1 , i ∈ K t ∼ Categorical ( Softmax ( τ t log p θ ( ⋅ ∣ a t , c ) + ε ) )
ε ∼ Gumbel ( 0 , 1 ) \boldsymbol{\varepsilon} \sim \text{Gumbel}(0, 1) ε ∼ Gumbel ( 0 , 1 ) τ t \tau_t τ t
二次重掩蔽与阈值检查 (Secondary Remasking)
为了防止早期步骤中低置信度错误标记累积传播,在提交位置集K t \mathcal{K}_t K t
R t abs = { i ∈ K t | s t , i < η t abs } ∀ i ∈ R t abs , a t + 1 , i ← [MASK] \begin{aligned} & \mathcal{R}_t^{\text{abs}} = \left\{ i \in \mathcal{K}_t \;\middle\vert{}\; s_{t, i} < \eta_t^{\text{abs}} \right\} \\ & \forall i \in \mathcal{R}_t^{\text{abs}}, \quad a_{t+1, i} \leftarrow \text{[MASK]} \end{aligned} R t abs = { i ∈ K t s t , i < η t abs } ∀ i ∈ R t abs , a t + 1 , i ← [MASK]
η t abs \eta_t^{\text{abs}} η t abs [MASK],供后续迭代继续优化,直到γ T = 0 \gamma_T = 0 γ T = 0 a 0 \mathbf{a}_0 a 0