主要模型架构一览
交互式模型结构图谱
切换总览、VLA、WM、WAM 查看结构与变量传导。图内可缩放、拖动,或通过模型索引定位;复杂结构建议全屏查看。
VLA、WM、WAM 作为具身智能领域的三种代表性模型,它们的本质区别是:
- VLA 从观察和目标直接生成动作:。关键架构是多模态 Encoder / Backbone 与 Action Decoder。RL 主要改进动作选择,或者为它增加价值函数、轻量 Actor-Critic 等模块。
- WM 从当前观察和动作预测未来:。关键架构是状态表示和 Dynamics Model。它支持候选动作评估、想象式 rollout、规划与训练。
- WAM 则联合建模动作与未来世界:。关键架构是共享或耦合的世界与动作表示。实际系统可以是联合生成,也可以通过多个模块组合实现,不意味着所有 WAM 都有同一套网络。
VLA:Vision-Language-Action Model
VLA 主要关注机器人的动作究竟如何从多模态表征中产生。这部分涉及到的结构分支和代表性论文如下:
| 结构分支 | 重新选择的主论文 | 关键架构 | 必须保留的前作 |
|---|---|---|---|
| 离散动作 Token | FAST(RSS 2025) | 连续动作序列经频域压缩、离散化,再由自回归模型预测 | RT-2、OpenVLA |
| 生成式连续动作 Expert | RDT2(ICML 2026) | 7B VLM、RVQ、Flow Matching、动作生成蒸馏 | Diffusion Policy、Octo、RDT-1B |
| VLM + Flow Action Expert | π₀.₇(2026) | VLM、视频历史表征、连续动作 Expert、异构条件输入 | π₀、π₀.₅、π₀.₆ |
| 空间推理与分层动作生成 | MolmoAct2(2026) | 空间表征、离散推理与连续动作 Expert 的组合 | SpatialVLA、MolmoAct |
WM:World Model
WM 主要关注世界状态应该怎样表示、预测并用于决策。世界模型内部也存在明显不同的架构。尤其必须区分潜在状态动力学模型与高保真视频生成世界模型:它们都能预测未来,但其训练开销、预测对象、可微接口以及与 RL 结合的方式差别很大。这部分涉及到的结构分支和代表性论文如下:
| 结构分支 | 主方法论文 | 核心模型结构 | RL 接入方式 |
|---|---|---|---|
| 潜在状态动力学 WM | DreamerV3(Nature 2025) | Encoder + RSSM + Decoder / Reward Head | 在潜在状态中进行 Actor-Critic 学习 |
| 大规模想象式 WM | Dreamer 4(2025) | 视频 Tokenizer + 交互式 Transformer 动力学模型 | 世界模型内部生成轨迹并优化策略 |
| 特征空间 WM | DINO-WM(ICML 2025) | DINOv2 视觉特征 + 特征动力学预测器 | 使用预测特征进行动作规划,可扩展至 RL |
| 大规模视频机器人 WM | DreamDojo(ICML 2026) | 视频扩散模型 + 潜在动作 + 实体动作适配 | 可用于策略评估、模型规划和模拟训练 |
| 长时程因果视频 WM | WALL-SS(2026) | 多尺度自回归 + 动作条件 + 长期记忆 | 使用 RL 改进世界模型本身的动作一致性 |
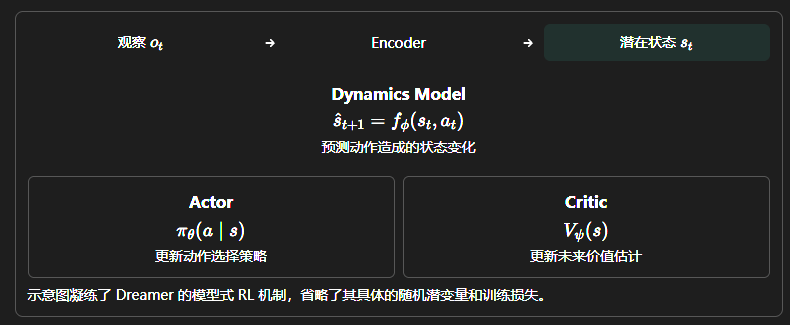
很多时候,WM 的结构直接决定 RL 设计,以 DreamerV3 为例(如图),这样的系统中,RL 的主要优化对象可以是 Actor 和 Critic,世界模型则通过环境数据学习状态转移、观察和奖励预测。DreamerV3 的核心就是在模型想象出的潜在轨迹上学习策略。相较之下,WALL-SS 的 RL 主要改进生成世界的动作遵循和时间一致性。两个系统都使用 RL,但被优化的神经网络不同。
WAM:World Action Model
WAM 在世界模型的基础上,进一步关心世界模型与动作策略怎样结合。同时,WAM 也需要进一步拆分。尤其不应把所有“具有视频预测能力的 VLA”自动归为同一种架构。
| 结构分支 | 推荐的主论文 | 核心结构特征 |
|---|---|---|
| 视频生成骨干 + 动作联合预测 | DreamZero(2026.02) | 预训练视频扩散模型,同步生成未来视频与动作 |
| 原生因果视频—动作模型 | LingBot-VA 2.0(2026.07) | 语义视觉动作 Tokenizer、因果预训练、稀疏 MoE、异步闭环执行 |
| 统一多模态世界与动作模型 | Cosmos 3(2026.06) | Mixture-of-Transformers,统一语言、视觉、视频、音频和动作的理解与生成 |
| 组合式 WM + 独立策略 | RISE(RSS 2026) | 动力学模型、进度价值模型与策略分离,实现模型内 RL |
模型架构怎样具体连接到 RL
接下来应建立一个贯穿综述的核心表格:模型中有什么模块、RL 更新什么、可以由哪篇方法论文验证。
| 模型类别 | 具体架构类型与代表模型 | RL 的具体优化位置 | 对应 RL 方法论文 | 优化方式 |
|---|---|---|---|---|
| VLA | 离散自回归动作模型(OpenVLA、FAST) | Action Token Policy,动作 Token 的生成概率分布 | 离散动作策略优化方向,待补直接对应的代表论文 | 对动作 Token 序列进行策略优化或偏好优化 |
| VLA | Flow Matching 动作生成模型(π₀、π₀.₅、π₀.₆) | Action Expert、优势条件与动作生成分布 | π*₀.₆ / RECAP | 利用价值模型估计优势,通过 Advantage-conditioned Policy Training 改进动作生成 |
| VLA | 冻结基础模型 + 轻量 RL 适配器(π 系列 VLA) | 新增 RL Token、轻量 Actor-Critic | RL Token | 冻结基础 VLA,通过离策略 RL 优化轻量动作策略 |
| VLA | Diffusion / Flow 动作策略(Diffusion Policy、Flow Policy) | 动作去噪网络、生成策略分布 | RL-100 | 在扩散去噪过程中进行 PPO 风格策略优化,并通过一致性蒸馏提高推理速度 |
| WM | 潜在状态动力学模型(DreamerV3、Dreamer 4) | 潜在空间中的 Actor、Critic | Dreamer 4、DreamerV3 | 通过世界模型生成想象轨迹,在潜在状态空间执行 Actor-Critic 学习 |
| WM | 动作条件自回归视频世界模型(WALL-SS) | 世界模型的视觉生成分布、动作条件动力学 | WALL-SS | 利用动作遵循性与长期一致性奖励优化世界模型的预测结果 |
| WAM | 组合式 WM + VLA(Dynamics Model + Value Model + Policy) | VLA 动作策略、想象轨迹的价值与优势估计 | RISE | 世界模型生成想象轨迹,价值模型计算优势,在想象空间中更新策略 |
| WAM | WM 与 VLA 交替协同优化架构(Action-conditioned WM + VLA) | 世界动力学模型与 VLA 动作策略 | VLAW | 利用真实机器人数据更新 WM,再用世界模型生成的交互数据改进 VLA,交替迭代 |
由此,RL Automation 章节便可以进一步研究:奖励、价值估计、数据收集、探索、环境构建和模型更新能否自动进行。